ビジネスの構造と意思決定

製造業・中国事業の実務を起点に、AI・DX、組織、行動科学、歴史などを横断。ニュースや研究の背後にある構造を読み解き、経営と現場の意思決定につながる視点を発信します。

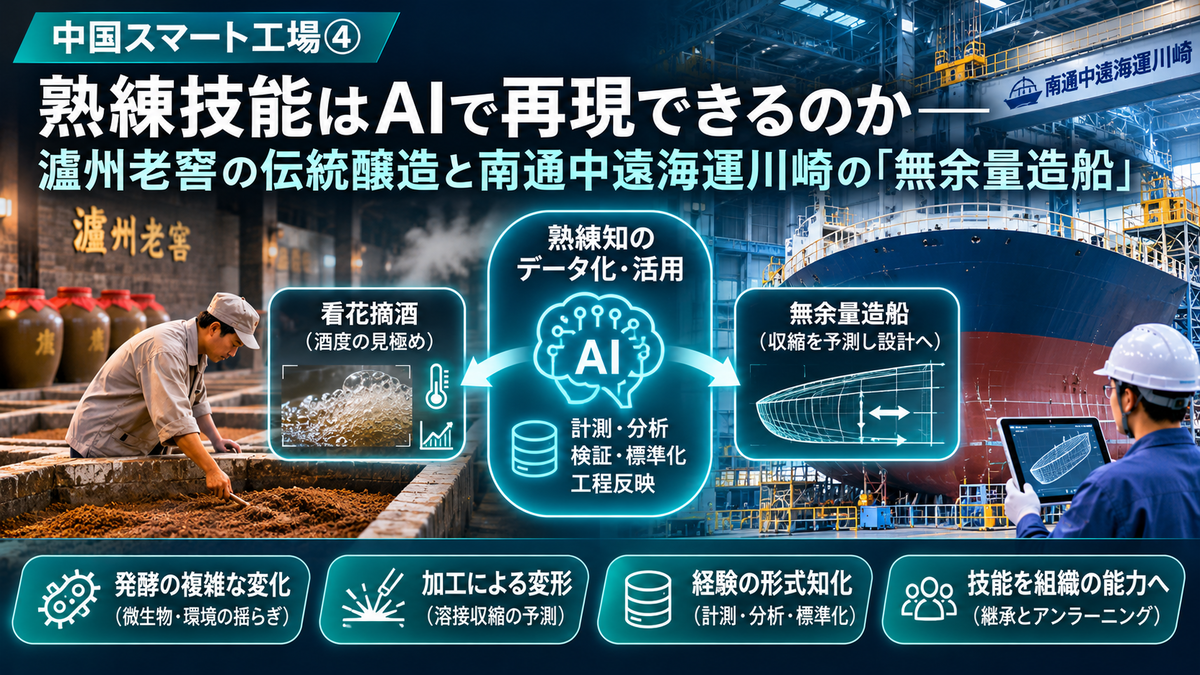
【中国スマート工場④】熟練技能はAIで再現できるのか――瀘州老窖の伝統醸造と南通中遠海運川崎の「無余量造船」

熟練者の「勘」は、何によって支えられているのか

皆さん、こんにちは。

同じ材料を使い、同じ設備を動かし、作業手順書に従っていても、熟練者が担当すると仕上がりが違う。製造現場では、そんな話を耳にすることがあります。

経験豊富な人は、温度や音、色や手触り、設備のわずかな動きから、数値に表れにくい変化を捉えているのかもしれません。しかし、それを単に「職人の勘」と呼んでしまえば、何を判断しているのか、なぜ品質が変わるのかを、他の人が学ぶことは難しくなります。

前回は、ZTE南京濱江工場のAIエージェントを取り上げました。そこで考えたのは、情報やモノの流れを自律化するためには、データだけでなく、業務ルールと判断の責任範囲を明確にする必要があるということです。

では、そのルールの源泉となる、長年の経験や試行錯誤はどうすれば残せるのでしょうか。

2026年10月26日、中国工業情報化部が公示した「領航級智能工廠」の育成候補34件には、一見すると対照的な企業が並んでいます。四川省の瀘州老窖(泸州老窖)と、江蘇省の南通中遠海運川崎です。[1]

前者のプロジェクト名は「非遺技芸の継承とAIの融合・革新を進める白酒スマート工場」、後者は「自主的なリーン化によって『無余量造船』を推進するスマート工場」と訳せます。

酒造と造船。扱う材料も製品も大きく異なります。しかし、熟練者が経験によって見極めてきた条件を、個人の技能から組織の能力へ変えようとしているという点では、共通した問いがあります。

今回は、すでに実現した取り組み、企業が公表した効果、2026年度の育成構想、筆者による考察を分けながら、二つの工場を見ていきます。公示された34件は、現時点で完成・正式認定された工場の一覧ではなく、育成候補である点にも注意が必要です。

なぜ、伝統醸造と大型造船を並べて考えるのか

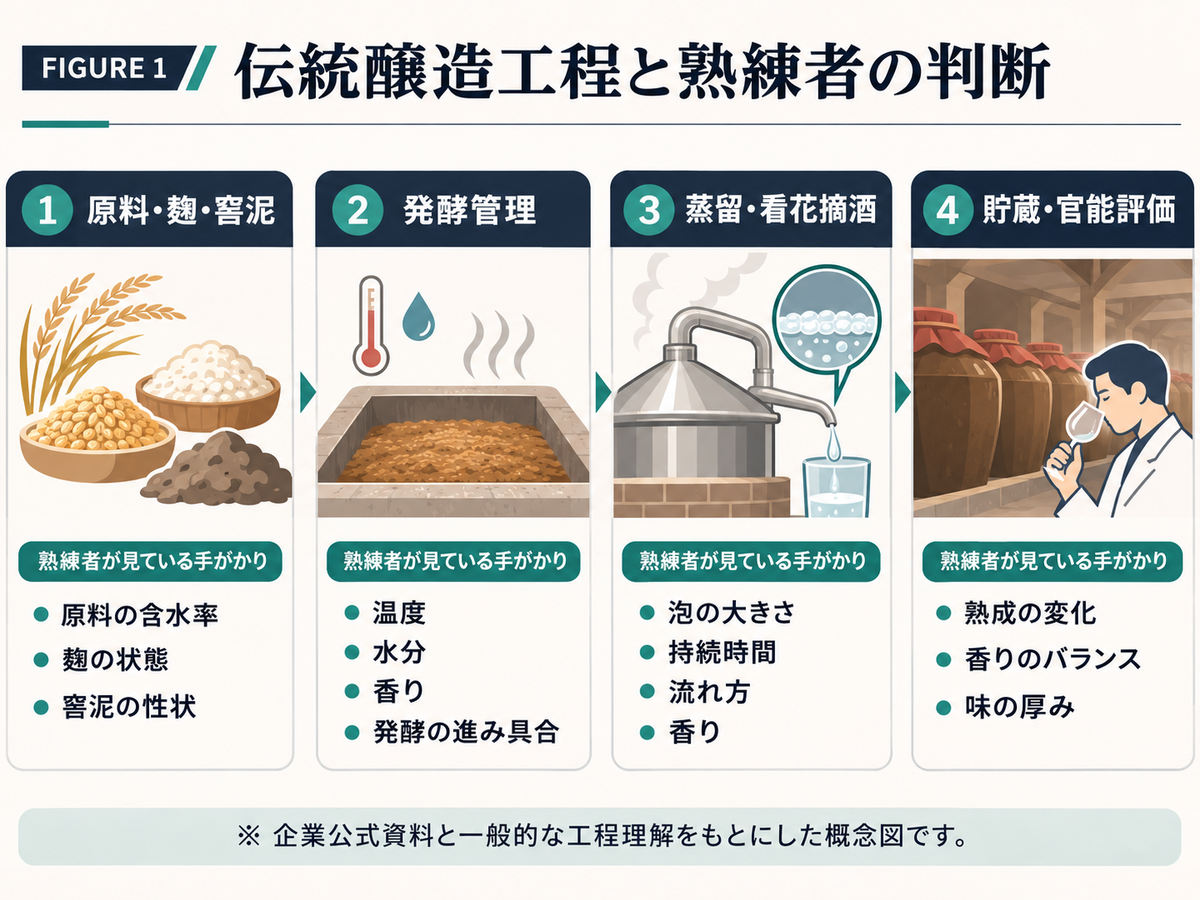
瀘州老窖では、原料や麹、窖池(発酵に使う泥でできた穴)の状態、蒸留中の酒液、熟成後の香味など、さまざまな要素が品質に関わります。とりわけ微生物が関与する発酵では、材料の状態と周囲の環境が複雑に影響し合います。

一方、大型船舶は何千枚もの鋼板を加工し、溶接し、巨大な船体ブロックへ組み上げます。切断寸法が正確でも、溶接時に金属が熱で膨張・収縮すれば、組立時の寸法は変わります。

酒造の課題は、複雑な環境の中で品質の一貫性を確保すること。造船の課題は、加工と接合に伴う変形を見越して精度を作り込むこと、と整理できます。

共通するのは、最終工程で良否を判定する前に、「結果を左右する条件」を上流で把握し、工程へ反映する必要があることです。

ただし、両者を単純に同じ数式やAIモデルで解ける問題として扱うつもりはありません。微生物が時間とともに変化する発酵と、材料特性や溶接条件を考慮する造船とでは、必要な計測も検証の方法も違います。

この違いこそ、スマート工場を考えるうえで重要だと思います。技術を導入する前に、何を再現したいのかを定めなければならないからです。

瀘州老窖――長い歴史を持つ醸造技能を、どう残すか

瀘州老窖の伝統的な白酒醸造技術は、2006年に中国の国家級無形文化遺産の代表的な項目へ登録されました。中国非物質文化遺産デジタル博物館は、窖泥の管理、麹の製造と評価、原酒の蒸留、貯蔵、調合・官能評価まで、多様な技術をその構成要素として挙げています。[2]

「伝統技能」という言葉からは、昔ながらの製法をそのまま守る姿が想像されるかもしれません。しかし、その中身を見ていくと、かなり精緻な観察と判断の積み重ねであることが分かります。

泡を見て酒を分ける「看花摘酒」

同社の公式サイトでは、蒸留時に流れ出る酒液の表面に生じる液珠、いわゆる「酒花」の大きさや持続時間から、酒度を判断する「看花摘酒」が説明されています。[3]

エタノールと水では表面張力が異なり、酒度によって泡の見え方が変わります。熟練者は、この視覚的な手掛かりを使って、取り出す原酒の区切りを判断します。

ここで興味深いのは、感覚的に見える仕事にも、物理的な根拠があることです。泡の状態は神秘的な情報ではなく、液体の性質が視覚に現れたものです。

もちろん、だからといって泡の画像だけで酒質評価のすべてが終わるわけではありません。香りや味わい、原酒の用途、前後の工程条件など、別の判断が関わります。

熟練者の技能を研究するなら、「何を見ているか」と「それによって何を決めているか」を分けて記録する必要があります。

例えば、泡の大きさと持続時間を動画から測定することは考えられます。その情報を酒度の測定値と照らし合わせれば、判断の根拠を検証することもできるでしょう。これは一般的な技術適用の例であり、瀘州老窖が当該工程へ特定の画像AIを導入済みだと示すものではありません。

発酵環境は、工場の中でも揺れ続ける

もう一つ、白酒醸造が難しい理由は発酵にあります。

温度、湿度、原料の含水率、酸度、窖泥の状態、麹に含まれる微生物、発酵期間。これらが相互に関わり、原酒の品質や風味へ影響します。

電子部品工場のように、温度や湿度を厳密に管理する環境を想像すると、同じ製造業でも条件の違いが見えてきます。発酵は生物が関与するプロセスであり、すべての変数を外側から完全に固定できるとは限りません。

瀘州老窖と江南大学による共同研究では、異なる年数や窖池内の位置にある窖泥を調査し、pH、水分、乳酸、微生物群集、代謝物などの関係を分析しています。2024年に大学が公表した研究紹介によれば、窖泥の位置や年齢によって微生物の状態が異なり、理化学的な条件が群集の変化に関係していることが示されています。[4]

また、2025年の共同研究では、自然発酵工場の環境微生物が場所や時間によってどう異なるかを分析しています。[5]

こうした研究は、熟練者が経験で捉えてきた発酵の複雑さを、測定し、比較し、説明するための土台になります。

しかし、微生物と品質の相関関係が見つかったことと、その結果を用いてすべての工程を自律制御できたことは別です。研究で得られた知見と、商用工場での安定した制御実績を混同してはいけません。
既存の智能醸造と、新しい育成構想を分ける

瀘州老窖の2024年ESG報告書によれば、2019年に完成した黄舣酿酒生态园では、自動化醸造設備などを導入し、同社は労働効率約75%向上、出酒率5〜10%向上、優良品質品比率10%向上などを公表しています。[6]

また、2024年に稼働を始めた智能包装中心は、高速充填ライン5本を備え、平均充填速度を毎時15,000本と公表しています。同報告書ではAI、デジタルツイン、製造・購買・物流システムの統合も紹介されています。[6]

ただし、包装ラインで毎時15,000本を充填できることは、発酵や官能評価という伝統技能のAI再現を直接証明しません。 さらに、園区のデジタルツインが使われていることだけから、発酵微生物をすべて予測・制御できると判断することもできません。

2026年10月には、別の智能醸造技術改造プロジェクト第1期について、竣工検収を通過し、試験的な生産に入る条件が整ったと地元メディアが報じました。[7]

これは事業の進捗として重要ですが、量産時の歩留まりや品質が長期間にわたって安定したという実績とは区別すべきでしょう。

今回の領航級育成候補は「非遺技能の継承とAIの融合・革新」という方向性を掲げています。しかし、個別の審査理由や、技能ごとのAI置換率、育成完了時の成果までは公示名簿だけで分かりません。[1]

AIは、伝統醸造の何を測り、何を判断できるのか

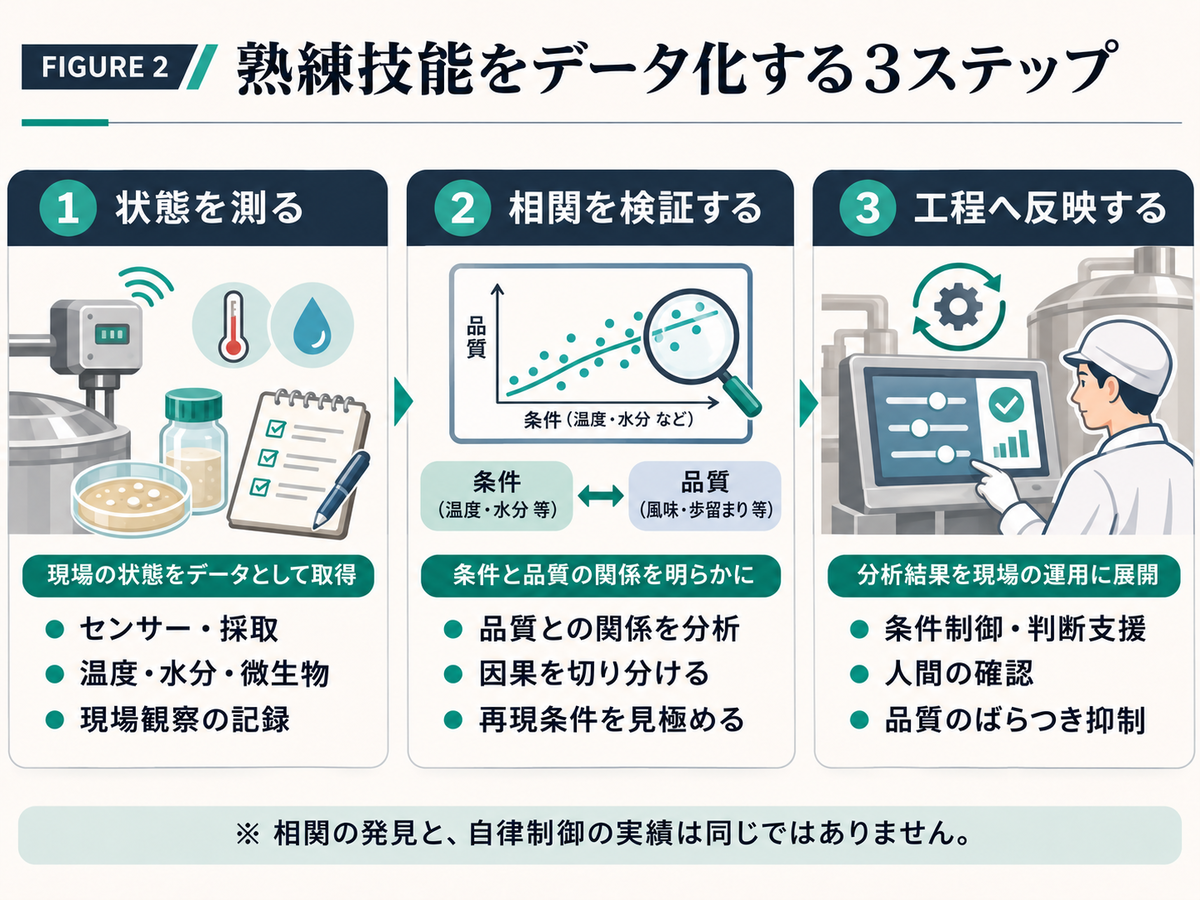
ここまでの事例から、私は技能のデータ化を三つの段階に分けて考えたいと思います。

第一は、状態を測ることです。

発酵中の温度、水分、pH、微生物の構成、香味成分など、観測可能な要素を記録します。測定方法や採取位置が違えば数字の意味が変わるため、「いつ、どこから、どう測ったか」まで残す必要があります。

第二は、品質との関係を検証することです。

例えば、ある温度帯で発酵させた原酒の品質が良かったとしても、温度だけが原因とは限りません。原料、麹、窖池の状態、季節、発酵期間などが同時に変わっている可能性があります。

AIが相関を発見することには価値があります。しかし、その相関が別の季節や別の窖池でも通用するのかを検証しなければ、再現性のある管理条件にはなりません。

第三は、工程へ反映し、結果を確かめることです。

条件変更を提案するだけなのか、作業者が確認して変更するのか、定めた範囲なら設備が自動制御するのか。どこまでを許可するかは、品質リスクや製品特性によって変わります。
ここに、伝統醸造の「再現性の壁」があると思います。

測定できる項目が増えても、見えていない変数が残ることがあります。長年の経験による判断をAIへ渡そうとするとき、何が物理的・生物学的に合理的なのか、何が過去の慣習なのかを確かめなければなりません。

私は、AIが熟練者に代わるかどうかを急いで結論づけるより、熟練者が気付いていた異常の兆候を、他の人も早く認識できるようにすることに大きな価値があると考えます。

「人の経験」をなくすのではなく、経験から学べる範囲を増やす。そのためのデータ化でありたいと思います。

南通中遠海運川崎――「無余量造船」はどう実現されたのか

一方の南通中遠海運川崎は、中国遠洋海運集団と日本の川崎重工業を背景に持つ造船企業です。大型船舶を建造する工場では、酒造とは異なる意味で熟練者の経験が精度を支えてきました。[8]

船を建造するには、数多くの鋼板を切断・曲げ加工し、溶接によってブロックへ組み立て、最後に巨大な船体へ接合します。

2018年に中国中央テレビの「焦点訪談」で紹介された事例では、2万TEU級コンテナ船に約1万3,000枚の鋼板が用いられ、100を超える大きなブロックへ組み上げるという説明がありました。[8]

問題は、図面どおりに切れば、必ず図面どおりの形に組み上がるわけではないことです。

溶接では加熱と冷却に伴って金属が変形し、収縮します。鋼板の材質、厚さ、形状、接合方法、溶接順序などが違えば、その変形の仕方も変わります。

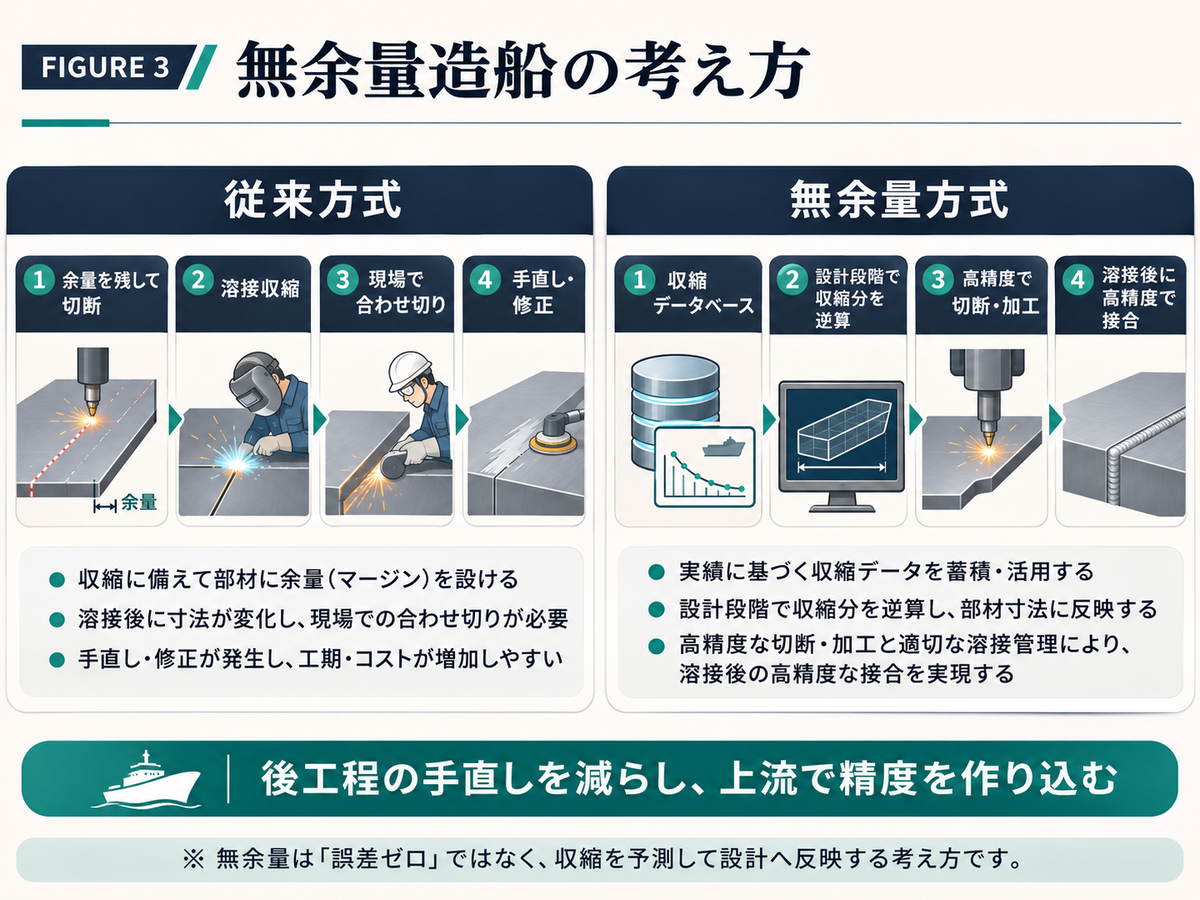
そこで従来は、多少の余分な部分、すなわち「余量」をあらかじめ設け、後工程で実物に合わせて切断・修正する方法が取られてきました。これは寸法の不確実性に対応するための合理的な手段でもあります。

しかし、後で修正することを前提にすると、切断、測定、再加工、部材の移動などが必要になります。作業が増えるだけでなく、ブロックの接合が遅れれば、後工程の計画にも影響します。

「余分を残して、後で合わせる」からの転換

南通中遠海運川崎が取り組んできた「無余量造船」は、こうした後工程での修正を減らす考え方です。

2018年の取材で、同社の製造部門幹部は、長年にわたって鋼板の収縮量を統計的に分析し、大規模なデータベースを作成してきたと説明しました。そして設計段階で、そのデータを各鋼板へ反映することによって、加工後に必要な寸法へ近づけていると紹介しています。[8]

つまり、溶接しても収縮しない鋼材を使うわけではありません。

収縮が起きることを前提に、その量を予測して先に設計へ織り込む。 これが重要な発想です。

「無余量」は、製造中の寸法誤差が物理的にゼロであるという意味ではありません。発生する変形を管理し、余分な修正代を設けずに組み立てられる条件へ近づける取り組みです。
私は、この方法には設備投資以上の変化があると考えます。

「後で現場が調整すればよい」と考えるのではなく、「後で調整しなくてよいように、設計と加工の段階で何を決めておくか」へ仕事の重心を移すからです。

もちろん、あらゆる余量を一律に禁止することが合理的だという話ではありません。材料や工程の変動が大きいところでは、補正や修正の余地を残す必要もあるでしょう。大切なのは、余量の有無そのものではなく、なぜその余量が必要なのかを説明できることです。

なぜ、これは「AIを入れた話」だけではないのか

注目したいのは、この取り組みが、2026年の領航級育成候補に選ばれるはるか以前から続いてきたことです。

同社は2018年の取材時点で、20年近い試行錯誤と加工・設計データの蓄積を説明しています。また2012年には智能造船を転換の方向と定めたと報じられました。[8]

工場で積み上げた寸法データや不具合の経験を、次の船舶の設計へ戻す。こうした仕組みがなければ、装置だけを新しくしても同じ精度を再現できるとは限りません。

2024年には南通市政府の公式サイトで、同社の鋼板曲げロボットの稼働が紹介されています。[9] 2026年5月の中国交通報でも、大型船舶の設計・建造と智能製造への取り組みが報じられています。[10]

ただし、2024年のロボット導入や2026年の船舶建造実績を、2026年度の領航級育成プロジェクトだけの成果として扱うことはできません。今回の候補名簿は、既存の能力をさらに高度化するための育成対象と読み分ける必要があります。[1]

熟練者の経験を、設計・加工・品質管理へ組み込む

では、加工時の経験や測定結果を、どうやって次の製品の精度へつなげるのでしょうか。

私は、設計、加工、測定、改善という循環で考えるのが分かりやすいと思います。

最初に設計段階で、材料や工程に合わせて収縮を見込みます。実際に加工・溶接したら、完成寸法や組立時のずれを測定します。予測と実績に差があれば、その条件を記録し、次の設計や作業標準に反映します。

これを繰り返せば、同じ誤差を発生させるたびに現場が修正するのではなく、誤差の発生自体を減らす方向へ進める可能性があります。
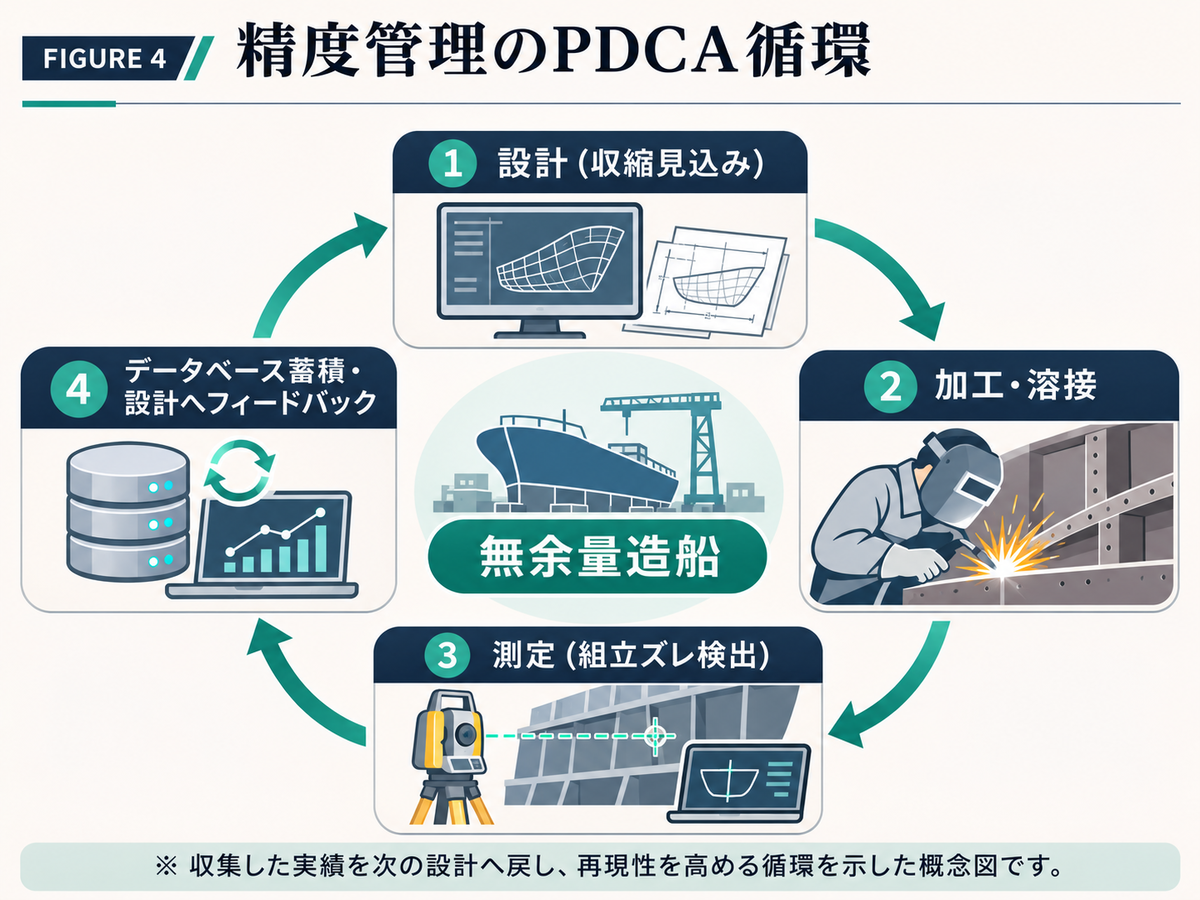
2018年の取材には、さらに印象的な取り組みが紹介されています。

同社では作業者の作業を動画で撮影し、ある30分の作業を177の動作へ分解して、作業方法を検討してきたというものです。また、溶接ロボットの動作指示や加工条件にも、蓄積したデータと工程経験を使っていたと説明されています。[8]

ここに、熟練技能のデータ化を考えるうえでの重要な違いがあると思います。

動画に残すだけなら、熟練者の動きを後から見ることはできます。しかし、その動作が必要な理由や、不要になった動作が何かを分析しなければ、作業を改善したことにはなりません。

作業を177に分けたという数字そのものが重要なのではありません。一つひとつの作業に、どのような目的と結果があるのかを議論した点に意味があります。

熟練者のやり方をそのまま保存するのではなく、そこで得られた成果を検証し、より良い方法へ変える。これこそ、個人の経験を組織へ移す作業ではないでしょうか。

そして、この循環が実際に機能するには、設計部門だけでも、製造部門だけでも足りません。

図面上で合理的な条件を設定しても、現場の治具や設備では再現できないかもしれません。現場で工夫した改善が設計データへ戻らなければ、次の船ではまた同じ調整が必要になります。

精度管理を高度化することは、測定装置の導入だけではなく、設計と製造の間の仕事のつなぎ方を変えることでもあるのです。

二つの工場に共通する「技能のデータ化」

ここまでの二つの事例を比較すると、取り組みの方向性と難しさが見えてきます。
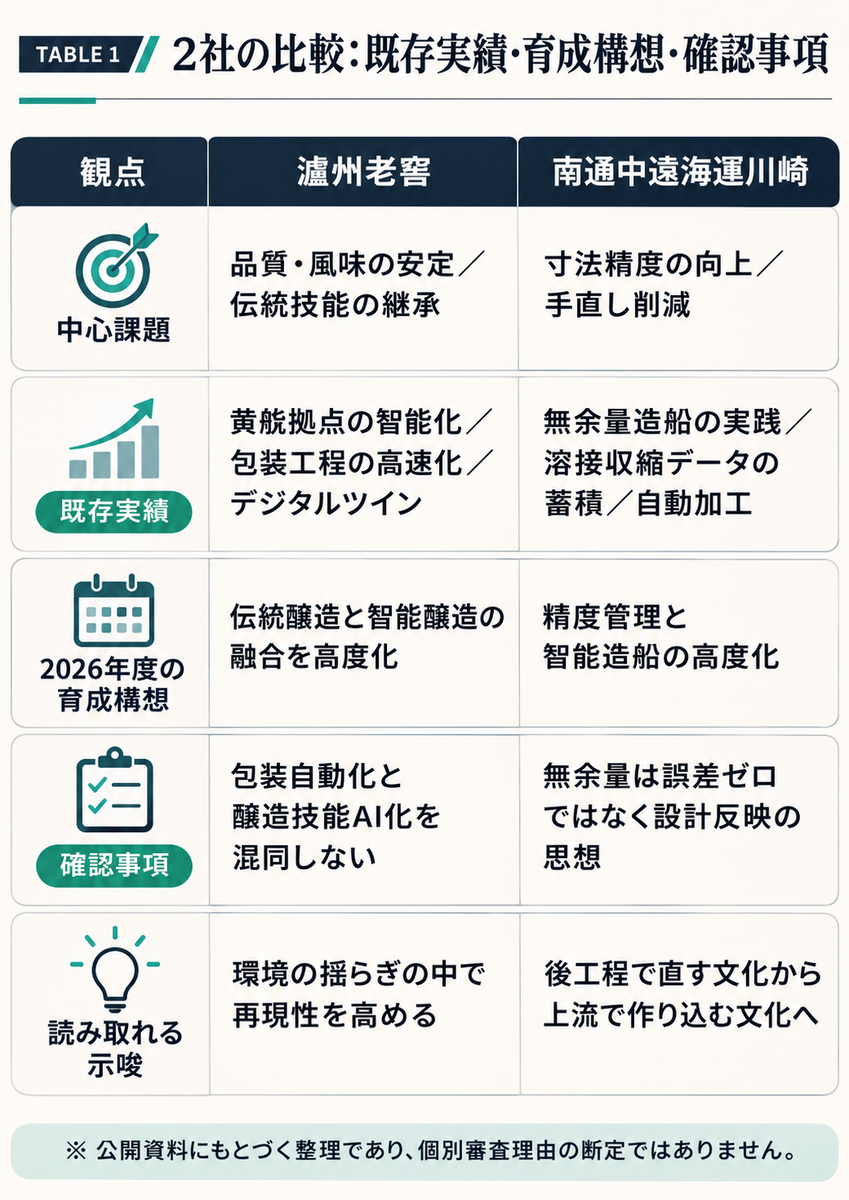
瀘州老窖は、発酵環境や微生物、酒質の関係を解き明かそうとしています。南通中遠海運川崎は、溶接収縮や加工の経験を、上流の設計へ戻す仕組みを蓄積してきました。

共通するのは、熟練者の判断を「正解」として保存することが目的ではない点です。

何を見て、何を判断し、どういう結果が出たのか。その関係を検証することで、他の人にも理解できる条件を増やそうとしているのだと思います。

一方で、両社ではデータの性質が違います。造船では寸法や収縮量など、物理的に計測できる指標を比較的扱いやすい一方、白酒には微生物の複雑な変化や香味評価といった多次元の要素があります。

したがって、同じ「形式知化」という言葉でも、成功の測り方は一律ではありません。

第1回で紹介した中国の22項目の参考KPIに結び付けるなら、不良率、生産効率、設備利用率、資源利用率、コストなどが候補になります。しかし、実際の測定条件をそろえずに、業種の異なる工場を同じ数値だけで比較することはできません。
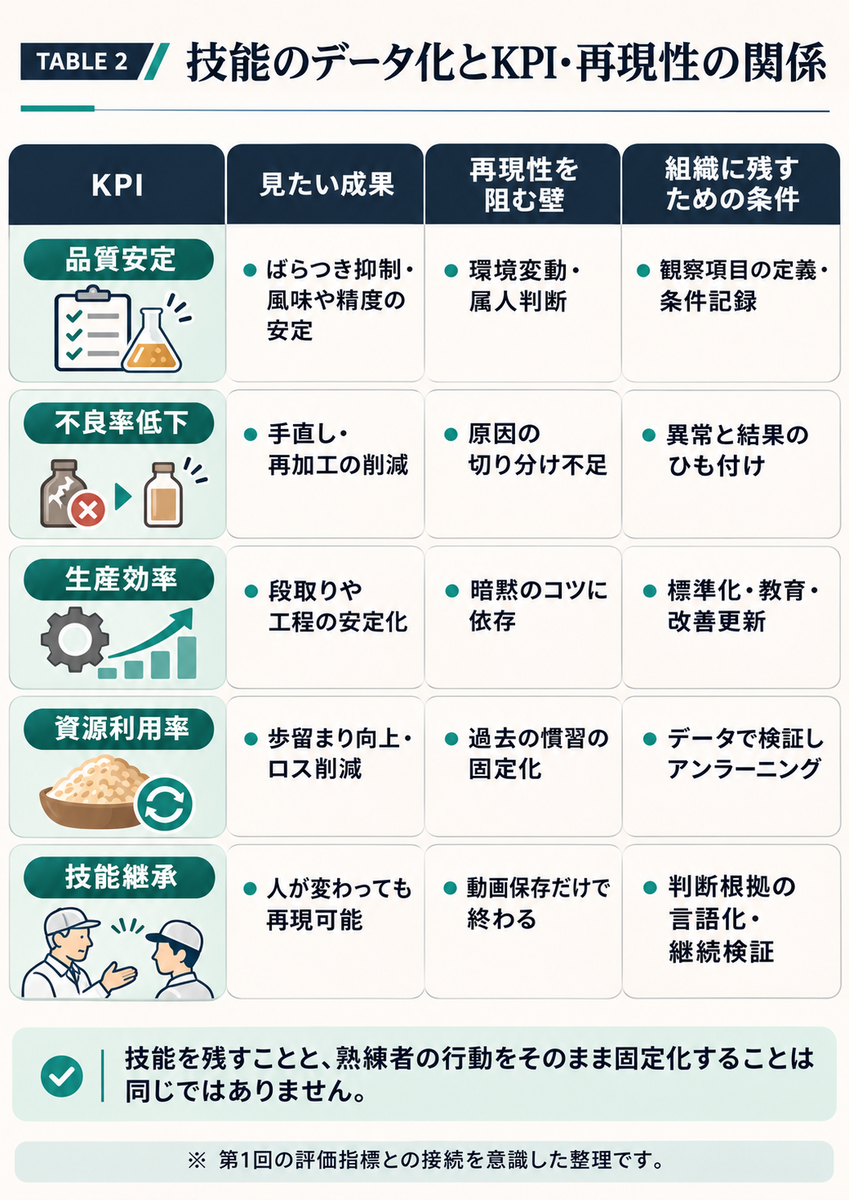
私はさらに、公式KPIとは別に「技能が組織へ残ったか」を確かめたいと思います。

担当者が交代しても品質を維持できるか。別の設備や場所でも同じ条件が通用するか。例外が起きたときに、なぜその処置を選んだかを説明できるか。

例えば熟練者が休むと生産や検査の判断が止まるなら、センサーやAIが増えていても、組織の能力になったとは言い切れないでしょう。

日系製造業は、何を標準化し、何を人に残すべきか

この二社から、日系製造業にも持ち帰れる問いがあると思います。

まず、自社で「この人にしか分からない」と言われる仕事を考えてみます。

検査結果の最終判定、設備の微調整、加工条件の設定、サプライヤーとの品質トラブル対応など、その仕事は本当に本人だけにしかできないのでしょうか。それとも、判断の根拠を記録していないために、他の人が判断できないのでしょうか。

最初から全自動化を目指す必要はありません。何が判断の入力情報なのか、どの条件で分岐するのか、例外が生じたとき誰に確認するのかを整理するだけでも、属人化の度合いは変わります。

しかし、もう一つ考えたいことがあります。

熟練者の経験を残すことと、熟練者のやり方を無条件で守ることは違うという点です。

古い設備の癖に合わせて生まれた手順、かつて必要だった過剰な検査、当時の治具でしか通用しなかった段取り。そうした作業が、現在でも合理的とは限りません。

もし動画やAIへそのまま取り込めば、不要な工程まで「熟練技能」として固定化してしまうおそれがあります。

ここでは、アンラーニング、つまり過去に身に付けた方法のうち、今は必要のない部分を見直すことも欠かせません。

技能継承にあたって、私は五つの問いを持ちたいと思います。

第一に、熟練者は何を観察しているのか。 音、温度、色、寸法、手触りなど、判断の手掛かりを特定できるでしょうか。

第二に、その判断はどんな結果と結び付くのか。 良品率や手直し時間だけでなく、後工程への影響まで確認できるでしょうか。

第三に、条件が変わっても再現できるのか。 材料、設備、担当者、季節が変わった場合に、どこまで同じ方法が使えるでしょうか。

第四に、過去の慣習を引き継いでいないか。 今の設備や製品に合わない動作を、必要な技能だと思い込んでいないでしょうか。

第五に、誰が更新し、誰が最終判断するのか。 手順書やAIモデルを作って終わりではなく、現場の結果を受けて管理条件を直せるでしょうか。

この五つは中国の育成要件をそのまま写したものではありません。今回の事例を踏まえ、私が技能継承と業務改善のために整理した問いです。

そして、すべてをデータに置き換えられないからといって、取り組みが失敗だとは思いません。むしろ、どこまでは数字で判断でき、どこからは人が確認すべきかを明確にできれば、品質管理も技能教育も進めやすくなります。

第3回で考えたAIへの権限委譲も、ここにつながります。根拠の曖昧な判断をそのままAIへ渡せば、判断を高速化するだけで、誤りや慣習も再生産してしまうからです。

まとめ――技能をなくすのではなく、組織の能力に変える

瀘州老窖の伝統醸造と、南通中遠海運川崎の無余量造船。製造するものは大きく異なりますが、どちらにも、熟練者が積み重ねた判断を計測・検証し、次の工程や次の世代へ活用しようとする姿勢が見えます。

一方では、微生物や環境の複雑さがあり、すべての品質判断を容易に定式化できるわけではありません。もう一方では、収縮の予測を設計へ組み込み、後工程の手直しを抑えるという長年のデータ蓄積があります。

スマート工場の価値は、人の技能をなくすことだけではなく、個人が積み上げた経験から、組織が学び続けられる仕組みをつくることにもあるのだと思います。

次回はいよいよ最終回です。34件の育成候補を横断し、一つの工場で形成した製造能力を、他の拠点やサプライチェーンへどう展開できるのかを考えます。

優れた技術や改善方法が生まれることと、それを別の現場でも再現できることは同じではありません。中国の「母工場」という考え方を手掛かりに、連載全体を総括したいと思います。

今回はここまでとします。 最後までお読みいただき、ありがとうございました。

参考資料

[1] 中国工業情報化部「关于2026年度领航级智能工厂项目培育名单的公示」(2026年10月26日)。育成候補34件と公示期間。 https://www.miit.gov.cn/zwgk/wjgs/art/2026/art_9f8bf509706f4905aaa1cbcb4110892a.html

[2] 中国非物質文化遺産デジタル博物館「泸州老窖酒酿制技艺」。2006年の国家級無形文化遺産登録と伝統技芸の説明。 https://www.ihchina.cn/art/detail/id/14366.html

[3] 瀘州老窖公式「非物質文化遺産・原酒醸造技術」。看花摘酒などの工程と判断方法。 https://www.lzlj.com/culture/unmaterial/

[4] 江南大学伝統醸造食品研究センター「泸州老窖…揭示浓香白酒窖泥微生物演替之谜」(2024年8月16日)。窖泥の微生物研究の紹介。 https://rctff.jiangnan.edu.cn/info/1070/2937.htm

[5] 江南大学伝統醸造食品研究センター「自然発酵工場の環境微生物の時空分布に関する共同研究」(2025年3月3日)。 https://rctff.jiangnan.edu.cn/info/1069/3015.htm

[6] 瀘州老窖「2024年ESG報告書」(2025年公開)、数智老窖・黄舣酿酒生态园・智能包装中心の項目。効率や生産速度は企業公表値。 https://www.lzlj.com/upload/file/20250521/1747789376467027450.pdf

[7] 川観新聞「泸州老窖智能酿造技改项目一期工程顺利通过竣工验收」(2026年10月15日)。第1期の竣工検収と試験生産条件。 https://cbgc.scol.com.cn/news/8059043

[8] 中国江蘇網/江海晩報「《焦点访谈》聚焦南通造船企业」(2018年7月24日)。溶接収縮データ、無余量造船、作業動作分析、合弁の背景。 https://jsnews.jschina.com.cn/nt/a/201807/t20180724_1783037.shtml

[9] 南通市政府「中远海运川崎『智能制造试点示范车间』」(2024年11月1日)。鋼板曲げロボットの導入事例。 https://www.nantong.gov.cn/ntsrmzf/tpxw/content/1da0daa1-326e-4aff-8738-f1e4e5469fcd.html

[10] 中国交通報「南通中远海运川崎:抢占超大型清洁能源船舶设计建造制高点」(2026年5月12日)。大型船舶の設計・建造と智能化の動向。 https://www.zgjtb.com/2026-05/12/content_516322.html

※本稿は2026年11月1日までに確認した公開資料に基づきます。2026年度の領航級は公示段階の育成候補であり、正式認定や個別育成目標の達成を意味しません。企業公表数値は公表された範囲の情報であり、第三者による測定条件の独立検証を意味しません。仮想的な技術適用例、業務比較、日系製造業への示唆は筆者による考察です。
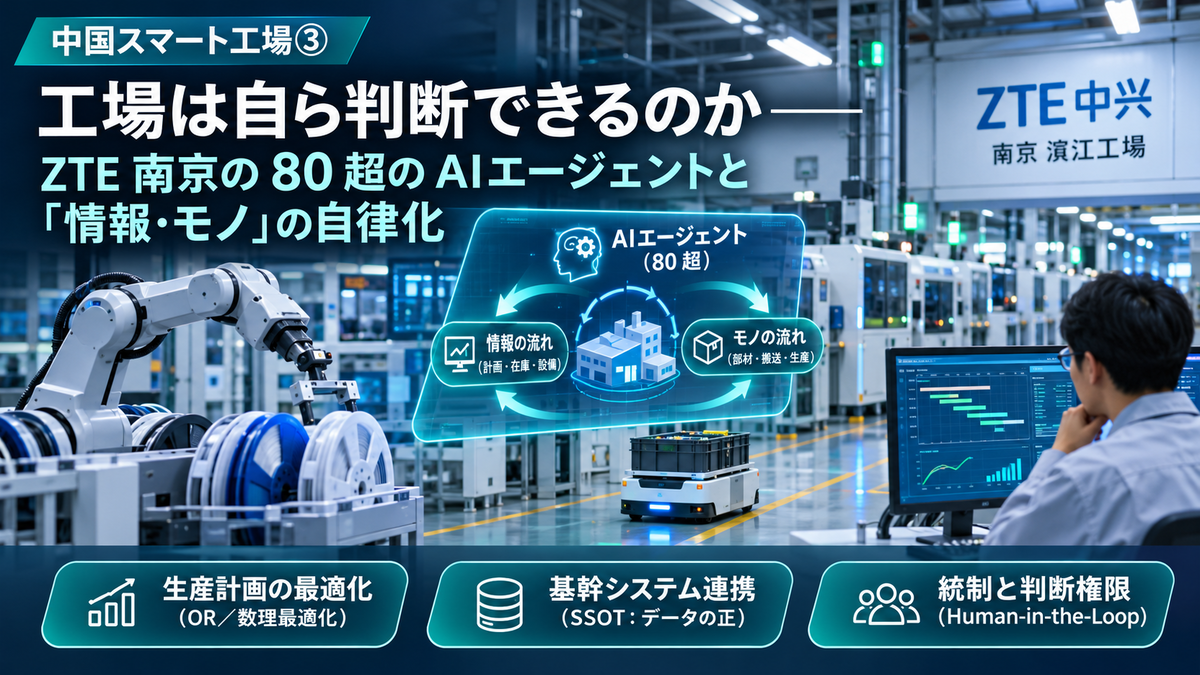
【中国スマート工場③】工場は自ら判断できるのか――ZTE南京の80超のAIエージェントと「情報・モノ」の自律化

工場の判断を、AIに任せられるのか

皆さん、こんにちは。

部材が予定どおりに届かなくなったとします。生産計画を変更し、別の製品を先につくる。画面上では順番を入れ替えるだけに見えるかもしれません。

しかし現場では、必要な部材を集め直し、設備の段取りを調整し、検査の準備や出荷予定も変更しなければなりません。

前回、小米汽車の大型一体鋳造と一汽フォルクスワーゲンの多車種混流を取り上げました。製造工程を集約するにしても、異なる製品を柔軟につくるにしても、設備の性能だけでは工場は動きません。

変化に合わせて情報を更新し、人や設備へ指示し、実際のモノの流れを変える仕事があります。

この調整をAIが担えるとしたら、工場はどう変わるのでしょうか。

2026年10月26日、中国工業情報化部は「領航級智能工廠」の育成候補34件を公示しました。その一つが中興通訊(ZTE)の南京濱江工場です。
公示されたプロジェクト名は「多智能体驱动『双流』自主流转的通信及算力设备智能工厂」。複数のAIエージェントにより、「情報の流れ」と「モノの流れ」を自律的に連動させる工場、と理解できる名称です。[1]

ZTEは同日、南京濱江工場に80超のAIエージェントを配備し、製造・運営管理の各業務に展開していると発表しました。[2]

ただし、ここでいう「自律化」を、AIが工場のすべてを人間抜きで判断・実行することと同一視してはいけません。

どの判断を自動化できるのか。何を既存システムに任せるのか。そして、どこから人間の責任になるのか。 今回はこの三つを中心に考えます。

なお、2026年度の34件は本稿執筆時点であくまで「育成候補」です。既存の工場実績、ZTEが発表した改善数値、今後の育成構想、筆者による一般的な考察を区別して記述します。

ZTE南京――5G工場からAIエージェントの工場へ

ZTE南京濱江工場は、5G通信機器やサーバーなどを製造する工場です。80を超えるAIエージェントという数字だけを見ると、短期間で工場の仕組みをAIへ置き換えた印象を受けるかもしれません。

しかし、同社が2024年11月に公開した技術記事を読むと、長い準備の過程が見えてきます。[3]

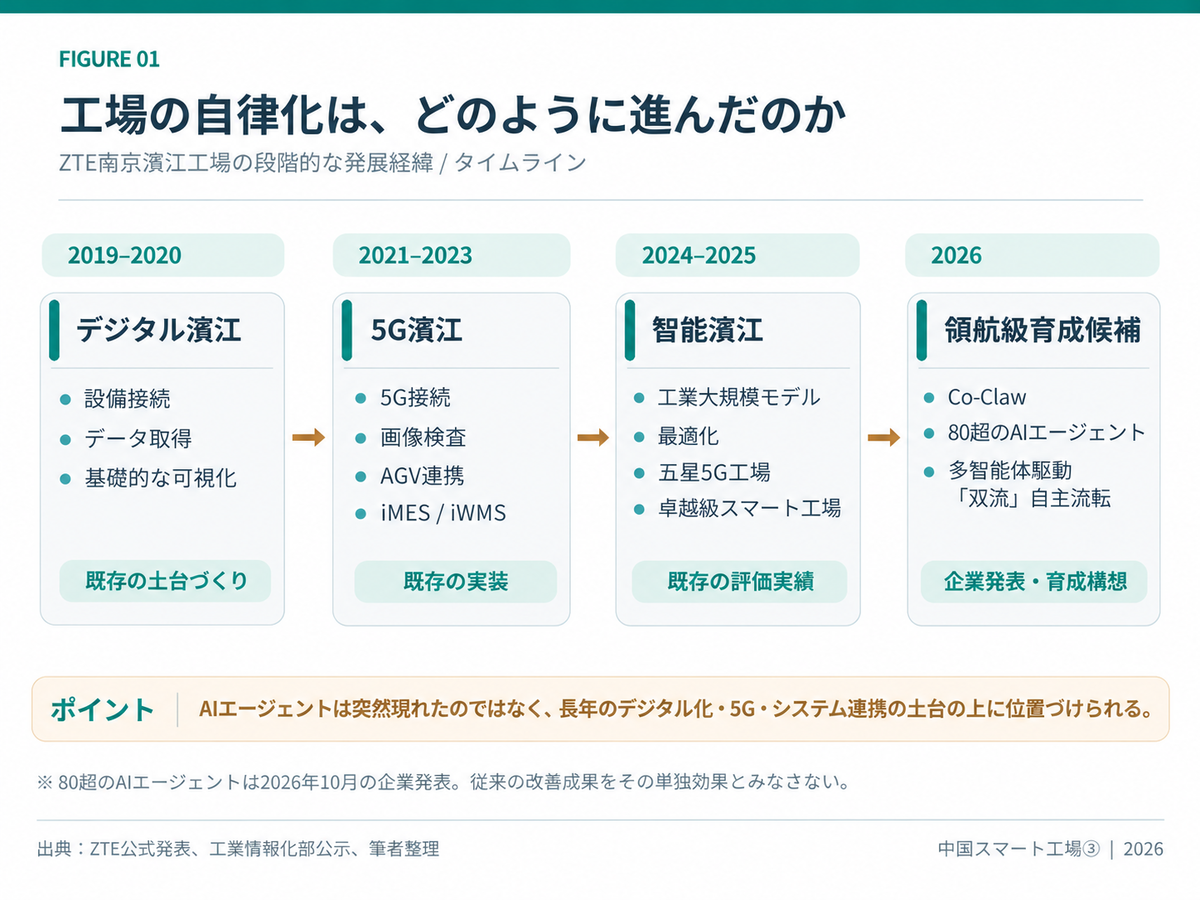
ZTEは工場の発展を「デジタル濱江(2019〜2020年)」「5G濱江(2021〜2023年)」「智能濱江(2023〜2026年)」の三段階で計画しました。

最初に設備接続とデータ収集を進め、その後、5Gを利用した画像検査やAGV(無人搬送車)の配車などを展開し、さらに工業大規模モデルを活用した判断・実行へ進むという構想です。

2024年8月には、ZTEの説明によれば中国初の「五星5G工場」として認証されました。

2025年9月には「卓越級スマート工場」に選定され、同社は工場自動化率82%、生産効率42%向上、不良品率47%低下などを公表しています。[4]

この時系列で重要なのは、AIエージェントの前に、設備がつながり、現場の状態がデータとして把握できる環境を整えてきたことです。

データを集めるだけなら、設備のセンサーやバーコードから実績を取得すればよいかもしれません。

しかし、収集した情報を生産計画と結び付けるには、製品番号、部材番号、工程順序、設備能力、在庫位置などの意味をそろえる必要があります。

設備ごとに同じ「完成」という言葉の意味が違えば、工場全体の判断には使いにくくなります。

ZTEは2024年の技術記事で、5Gや工業ネットワーク、データ基盤、星雲工業大規模モデル、数理最適化技術を組み合わせる方向性を説明しています。[3]

新しいAIエージェントが働くためには、こうした従来の投資が重要な土台になっていると考えられます。

AIを導入すれば、現場の情報が自動的に整うわけではありません。むしろ、AIへ任せたい判断が増えるほど、その判断を支えるデータを正しく整える仕事が増えるのではないでしょうか。

80超のAIエージェントは、何をしているのか

ここで「AIエージェント」という言葉を整理しておきます。

生成AIに作業手順を質問し、回答を得るだけなら、基本的には人が読んで次の操作を行います。

AIエージェントは、与えられた目的や条件に応じ、情報の参照、処理の呼び出し、結果の確認など、複数の段階をまたいで仕事を進める仕組みです。

例えば「今日の欠品リスクを調べて」と質問したとき、AIが注意すべき製品を文章で列挙するだけなら情報提供です。

受注・在庫・購買・生産予定を照合し、必要な追加確認を行って担当者へ対応案を提示するなら、業務により深く関わります。さらに決められた条件の下で倉庫への補充指示まで発行するなら、AIの判断が実行へつながります。

ただし、需要予測、数理最適化、従来のワークフロー自動化とAIエージェントは、きれいに切り分けられるものではありません。既存の計算機能や業務システムをAIエージェントが呼び出す構造もあり得ます。

新しい名前が付いたから、すべての計算方法が新しくなったとは限りません。

ZTEは2026年4月に企業向けAIエージェント基盤「Co-Claw」を紹介し、南京濱江で生産ライン物流、設備運用、巡回点検、エネルギー管理などに適用する事例を公表しました。[5]

同年10月の発表では、80超のAIエージェントが製造・運営管理のプロセスに展開されたとしています。[2]

この二つの発表から、ZTEが単なる文書作成補助ではなく、現場の運営や機器への指示と結び付くAI活用を進めていることは読み取れます。

一方、80超の各エージェントが具体的にどのシステムを操作し、どの権限で稼働し、どれだけの時間を完全無人で実行しているかという全件一覧は、確認した公開資料からは分かりません。

つまり、エージェントの配備数は導入の広がりを示しても、意思決定の自律性をそのまま示す指標ではないのです。

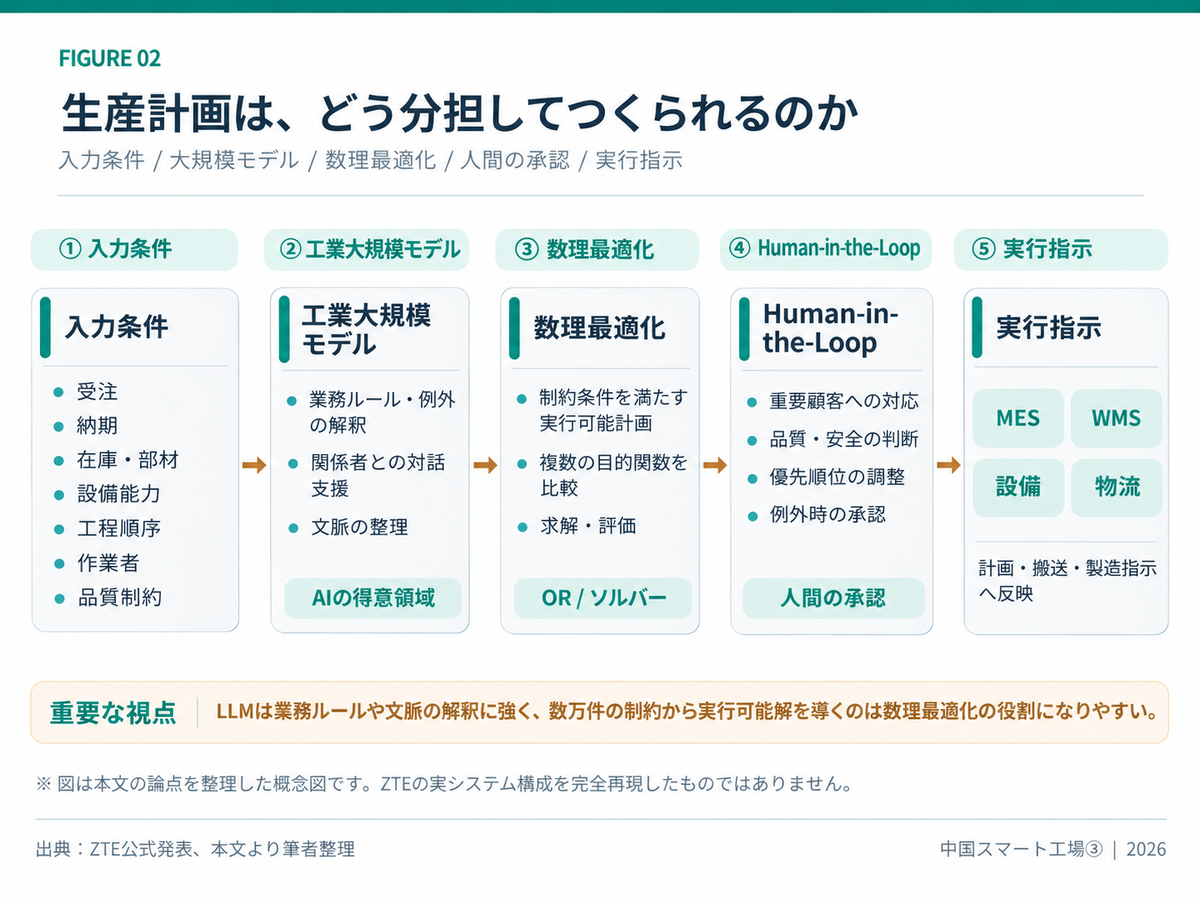
生産計画をAIが考える――何を最適化するのか

ZTEの事例で、私が特に興味深いのは生産計画です。

2024年のZTE技術記事には、数千件の受注、数万件の部材情報、百万単位の対応関係を扱う必要があると記されています。そこで考慮するのは、納期だけではありません。

設備の能力、工程順序、部材の充足、生産資源など、さまざまな制約条件です。[3]

製造業に携わったことのない人から見れば、注文を納期順に並べて製造すればよいと思えるかもしれません。しかし、納期が早い受注から生産しようとしても、必要な部材がそろっていなければ実行できません。

部材があっても、検査設備が満杯なら出荷を遅らせる可能性があります。一つのラインの稼働率を最大化すれば、別の工程に仕掛品が滞留することもあります。

ここでさらに難しいのが、何を「良い計画」と呼ぶのかという問題です。顧客への納期を優先するのか、設備の稼働率を上げるのか、在庫を減らすのか、段取り替えを減らすのか。

同じ条件でも、重視する指標が違えば別の計画が望ましくなる場合があります。

この計算を、汎用の大規模言語モデルだけで解いている、と理解するのは正確ではありません。

ZTEの2024年の資料は、工業大規模モデルと運筹优化(オペレーションズ・リサーチ、数理最適化)技術の組み合わせを明示しています。[3]

一般的には、自然言語の指示を業務上の条件に整理したり、関係システムを呼び出したりする役割と、多数の制約を満たす解を計算する役割を分けて設計できます。

工場では、最適化計算で実行可能な候補を求めることと、どの制約を守り、どこを人が承認するかを定めることが必要です。

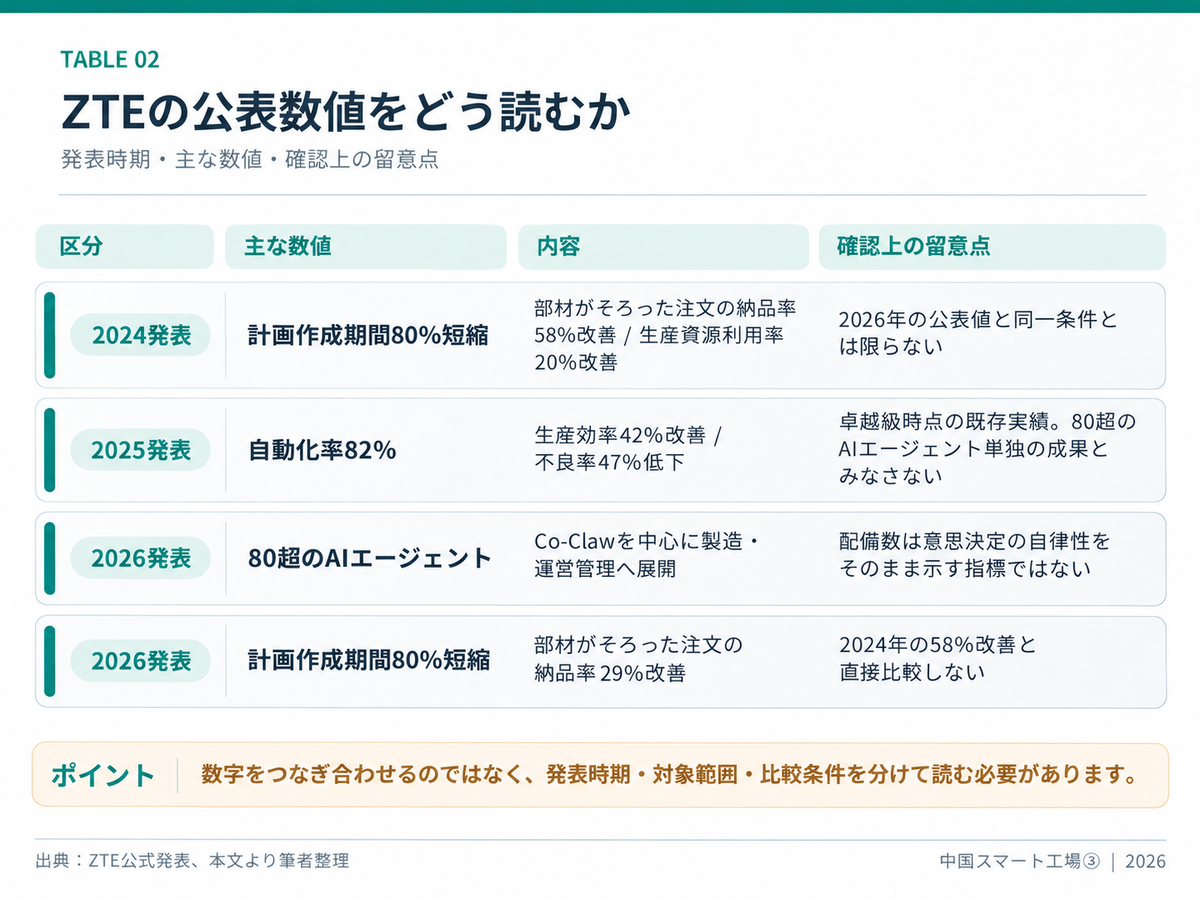
ZTEは2024年の記事で、受注の生産計画作成期間80%短縮、部材がそろった注文の納品率58%改善、生産資源利用率20%改善などを発表しました。[3]

これらは2024年に公表された数値であり、2026年10月に配備された「80超のエージェント」だけによる成果ではありません。

また、これらの公表値だけでは、何を分母・分子とする納品率なのか、改善期間や対象品目が何か、どの費用が削減されたかまでは確定できません。数字を引用するときは、改善の対象を取り違えないことが重要です。

私はここに、AI活用の実務的な要点があると思います。AIが提案する計画は、企業が何を優先するかを反映した結果です。最適化する前に、「何を優先してよいのか」を組織が決めなければなりません。

生産計画を変えた後に残る仕事

仮にAIが、ある製品の生産を翌日に変更する案を出したとします。

その案が部材と設備の制約を満たしていたとしても、顧客へ通知する必要があるか、仕入先への指示を変えるべきか、夜間作業や緊急輸送が発生するか、といった問題は残ります。

計算上の最適解が、会社にとっての最適解と同じとは限りません。特に、目的関数へ入れていない費用や顧客との約束は、計算結果に十分反映されない可能性があります。

そのため、AIによる生産計画の高度化は、担当者を不要にする取り組みというより、担当者が見落としやすい制約を見えるようにし、検討と判断の質を高める取り組みとして考えたいと思います。

情報の流れが、モノの流れを動かす

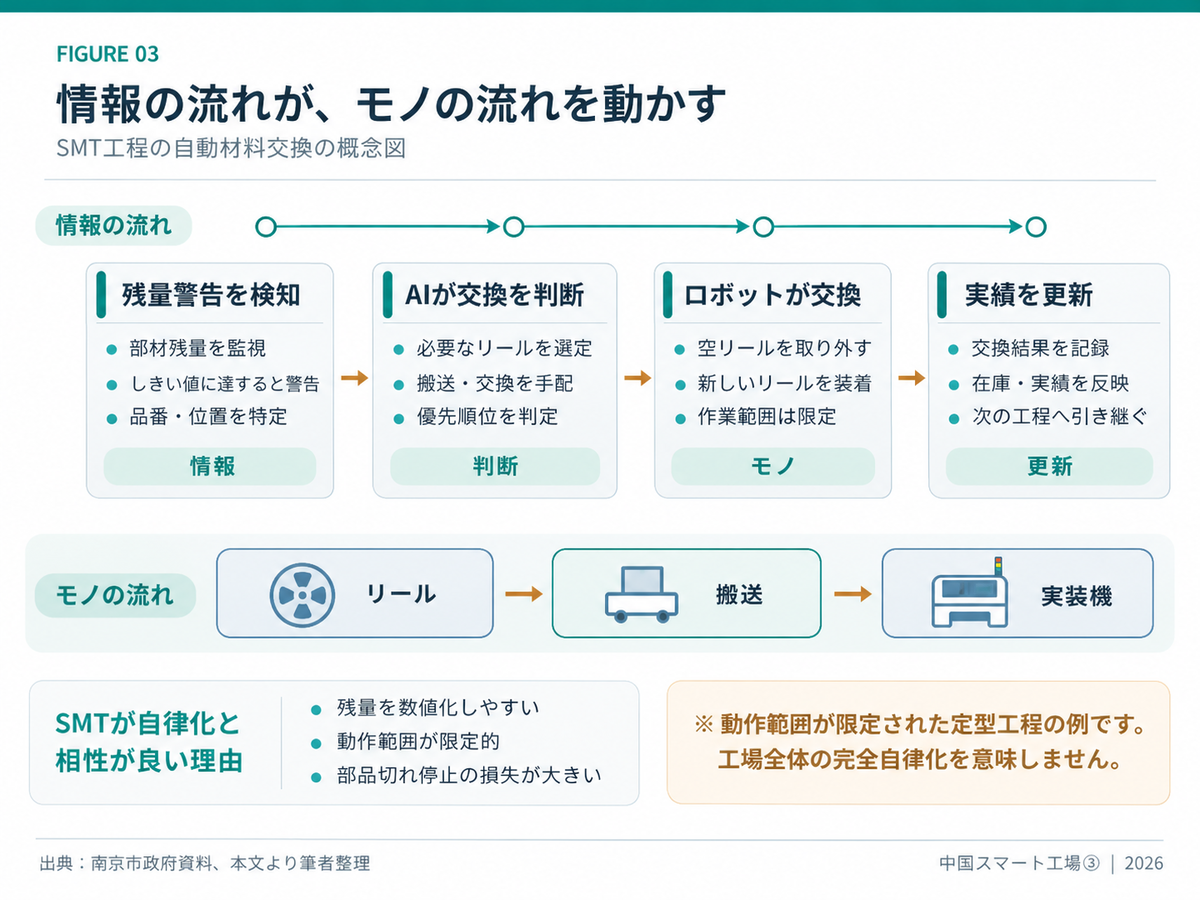
今回の領航級育成候補のプロジェクト名に含まれる「双流」は、情報の流れとモノの流れを組み合わせた表現です。私はこの言葉に、ZTE南京の取り組みの特徴が凝縮されているように感じます。

判断が画面上で終わるなら、現場の仕事は変わりません。生産計画を変更したら、必要な部材のピッキング、搬送、設備への供給まで同じ内容で動く必要があります。

逆に、設備や搬送側で異常が起きたら、その結果を計画へ返さなければなりません。

南京市政府は2026年10月29日、南京濱江工場のSMT(表面実装)工程で、部材残量の警告を捉え、ロボットアームが空になったリールを取り外し、その時点で必要な新しいリールへ交換する取り組みを紹介しました。

同記事では、この一連の作業を人の介入なく実施すると説明しています。[6]

SMTとは、電子基板の所定位置へ電子部品を載せ、はんだ付けする工程です。部品供給に使うリールが空になれば、その部材を必要とする実装作業は継続できません。

製品や条件によっては、部材切れを防ぐための補充や材料交換が生産の継続性に直結します。

なぜ、この工程が自動実行に向くのでしょうか。一般論として、リールには部材品番や残量などを管理しやすい条件があり、交換する対象・設備・位置・動作が比較的限定されているからです。

どのリールを外すか、何を次に装着するか、交換後に何を確認するかを、手順と設備条件として定義しやすい領域と言えます。

ただし、残量を正しく把握し、部材を取り違えず、機械側の状態を確認し、安全に交換する仕組みは必要です。単にロボットアームを設置すれば完成するわけではありません。

残量の数値とリールの実物が一致しない場合、どう停止・再確認するかも設計に含まれます。

私が注目したいのは、判断を任せる範囲が、具体的な部材と設備の動作に限定されていることです。だからこそ、何を正常とし、どのような異常なら止めるのかを定められます。

この事例は、自律化を考える良い入口ですが、これだけで工場全体が人間なしで動くと結論付けることはできません。

工場には、定型的な部材交換だけでなく、品質不良の原因が複数にまたがる場合や、取引先と納期を再交渉する場合もあります。すべてを同じ仕組みで自動実行できるわけではないからです。

第2回の混流生産では、車両の順序変更に合わせて部材供給を変える難しさを扱いました。

今回のSMTの例も、対象や規模こそ違いますが、情報が正しく更新されても、実際の部材と機械の動きが一致しなければ生産は続かないという点でつながっています。

ERP・MES・WMSがあれば、AIエージェントは不要なのか

AIエージェントの話題では、「既存システムをAIに置き換える」という表現を見かけます。しかし、製造業の実務では、置き換えるより先に役割を整理すべきだと思います。

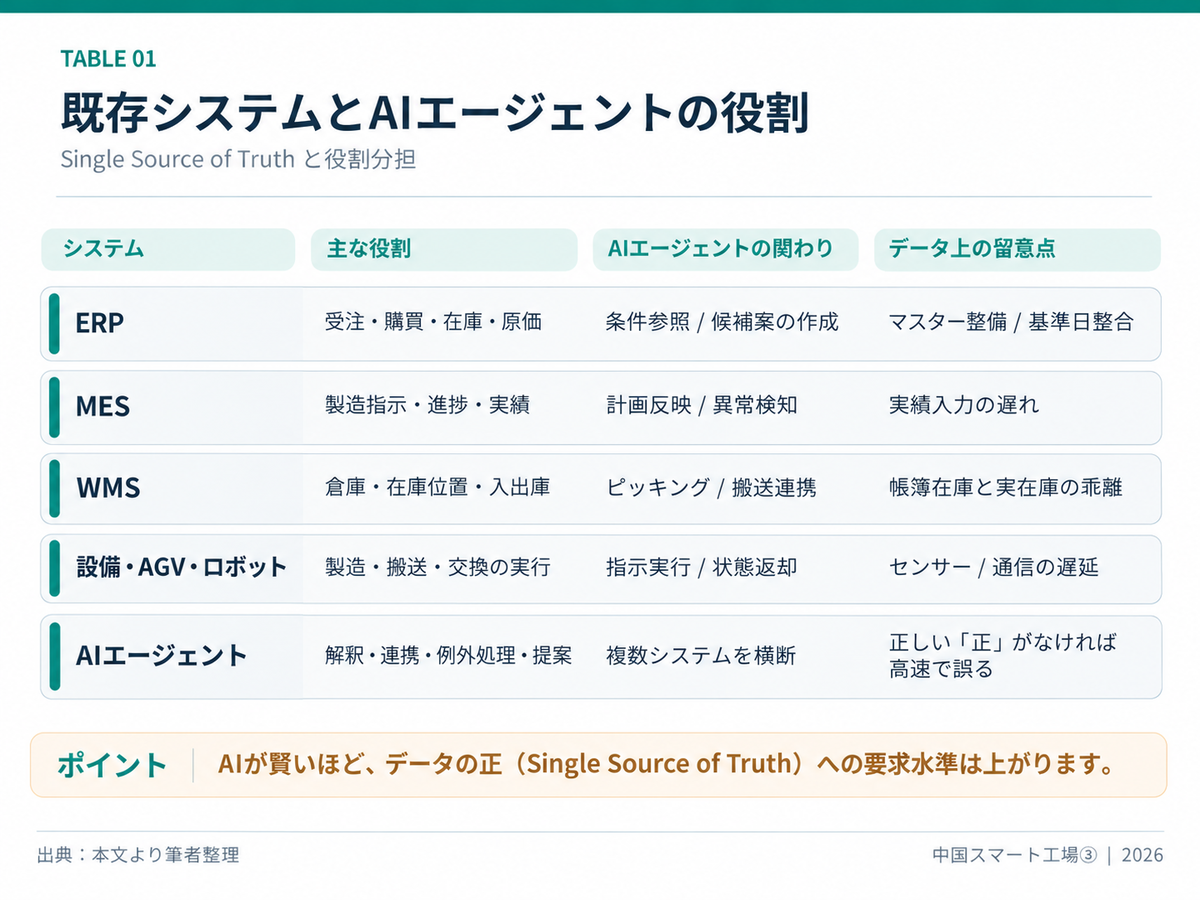
一般的にERPは、受注、購買、在庫、会計などの基幹データを扱います。MESは生産指示、進捗、工程実績を管理し、WMSは倉庫内の入出庫、保管位置や在庫管理を担います。

設備制御システムは、機械が安全に決められた動作を行うために存在します。

AIエージェントがどれほど高度化しても、存在しない在庫を物理的に出庫することはできません。設備の安全回路を飛び越えて生産することも認められません。

必要なのは、既存システムが持つ正確な情報と制約を利用し、権限の範囲内で判断や処理を連携させることです。

「どのデータが正しいのか」が決まっていなければ

例えば、WMSには部材が100個あると記録されていても、棚卸しをすると96個しか見つからない場合があります。MESの製造実績の入力が遅れているために、すでに消費した部材が在庫に残って見えるかもしれません。

また、ERPの品目マスターで代替部材が認められていても、現場の検査条件がまだ更新されていないこともあり得ます。

この状態でAIエージェントが在庫情報を読み取り、「部材は足りているので明日生産可能」と自動判断すれば、計画上は問題がなくても現場では部材不足になります。

AIの推論能力が高いほど、間違ったデータを正しいように使ってしまう危険があります。

ここで必要になるのが、いわゆるSingle Source of Truth――どの情報を正として扱うか、という考え方です。ただし、全データを一つのシステムへ集めればよいという単純な話ではありません。

受注残はERP、設備の停止状態はMESや設備制御、棚の現物確認はWMSと現場実績がそれぞれ担うように、データ項目ごとに正とする情報源、更新のタイミング、差異が出た場合の処理を決める必要があります。

時刻の問題もあります。五分前には存在した在庫でも、今は別の受注へ引き当てられているかもしれません。AIが判断した瞬間と、実際に出庫指示を実行した瞬間に状況が変わることもあります。

どの時点のデータを使い、実行直前に再確認するかという設計が欠かせません。

ZTEのCo-Clawについては、公式資料で既存システムやAMR制御との接続、権限管理などが説明されています。[5]

しかし、南京工場のERP・MES・WMS間でどのデータ項目を唯一の正としているのか、差異処理をどのように実装しているのかという個別設計までは、今回の公開資料では確認できません。

私は、AIを自律的に動かすほど、この地道なマスター管理と実績入力の即時性が重要になると考えます。AIの賢さと、AIが参照するデータの正しさは別の問題です。

AI導入の成果を、何で評価するのか

ZTE南京には、多くの改善数値が公表されています。しかし、数値が多いほど、評価は慎重に行う必要があります。

例えば、2024年11月のZTE技術記事では、受注生産計画の作成期間80%短縮、部材がそろった注文の納品率58%改善という数字が示されています。[3]

これに対し、2026年4月のZTE経営陣による発表では、計画期間80%短縮とともに、部材がそろった注文の納品率29%改善という数字が挙げられています。[7]

どちらもZTEの公表値ですが、測定期間、比較基準、対象注文などが同じであるとは確認できません。58%から29%へ悪化したとも、29%が追加の改善だとも断定できません。

2025年9月に公表された生産効率42%向上や不良品率47%低下についても、工場全体の段階的なデジタル化の成果として紹介されたものです。[4]

2026年10月に公表された80超のAIエージェント単独の効果として合算するのは不適切です。

また、南京市政府の2026年10月の記事には、製品不良率が40%以上低下したという記述もあります。[6] こちらも2025年の47%という数字とは測定条件をそろえていないため、直接比較しません。

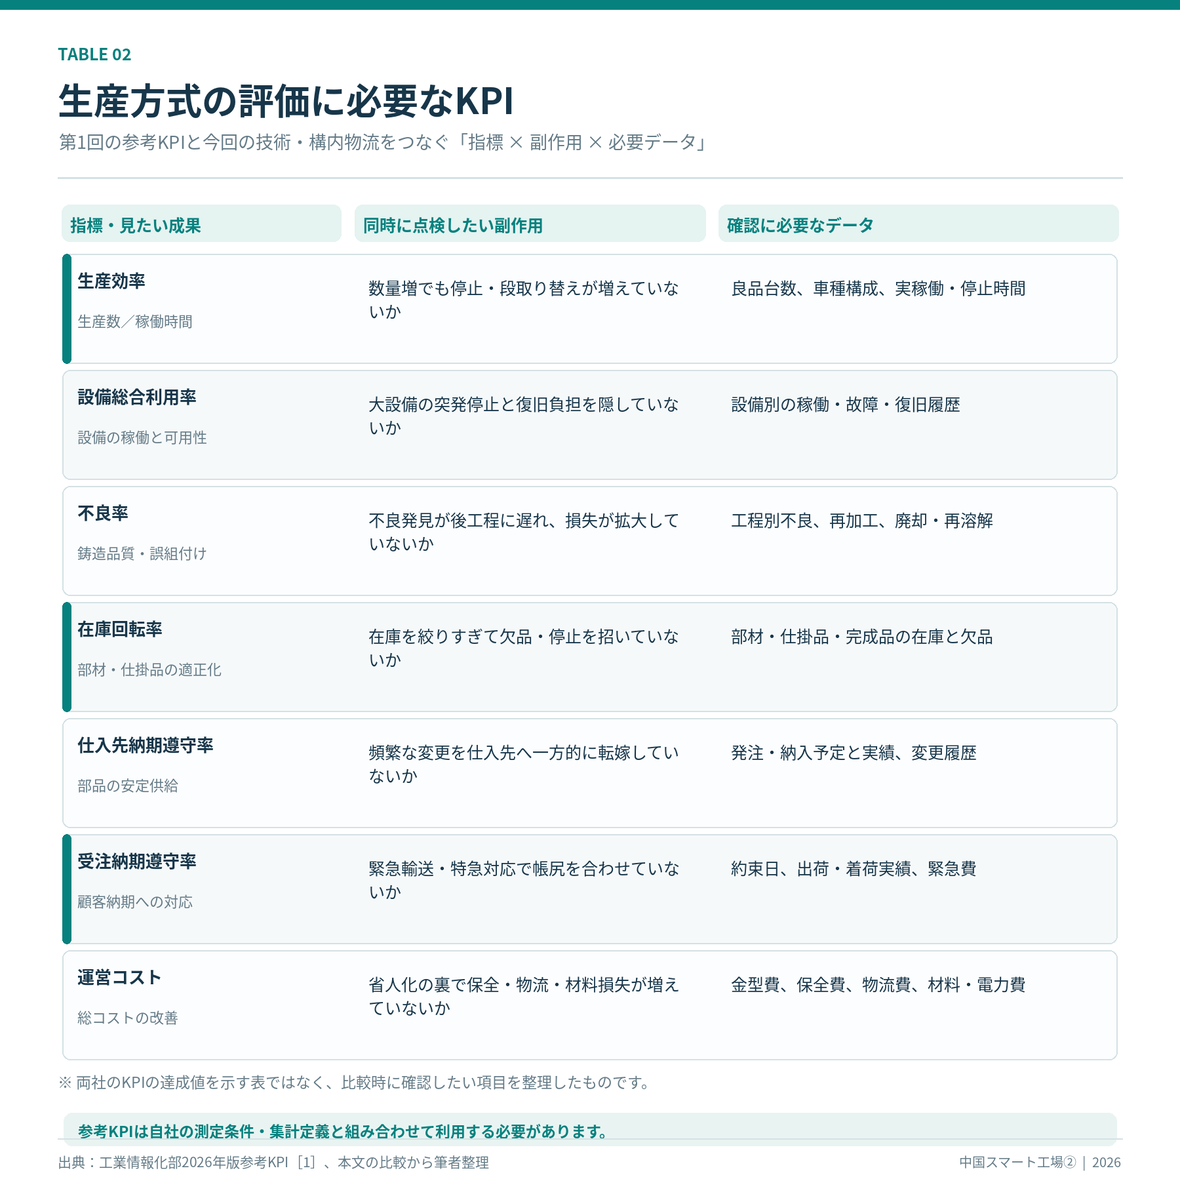
第1回で紹介した22項目の参考KPIに照らすなら、確認したいのはAIエージェントの数だけではありません。

受注納期遵守率、設備利用率、不良率、在庫回転率、生産効率、さらにはシステム運用コストなどがどう変化したかです。

ただ、私ならAI導入後の業務統制も併せて確認したいと思います。間違った指示が実行される頻度、例外発生時の復旧時間、担当者が承認に要する時間、処理を遡れる記録が残っているか。

これらは中国の22の参考KPIをそのまま写したものではなく、AIを実務に使う際の補助指標として筆者が加える視点です。

AIエージェントの数が増えたことを成果とするより、実務で何が改善し、その代わりにどのような新しいリスクと運用負担が生まれたのかを評価したいと思います。

AIが判断するとき、人間は何を担うのか

AIエージェントを工場に導入するとき、最後に残るのは技術の問題だけではありません。誰が優先順位を決め、その判断の結果を引き受けるのか、という組織の問題です。

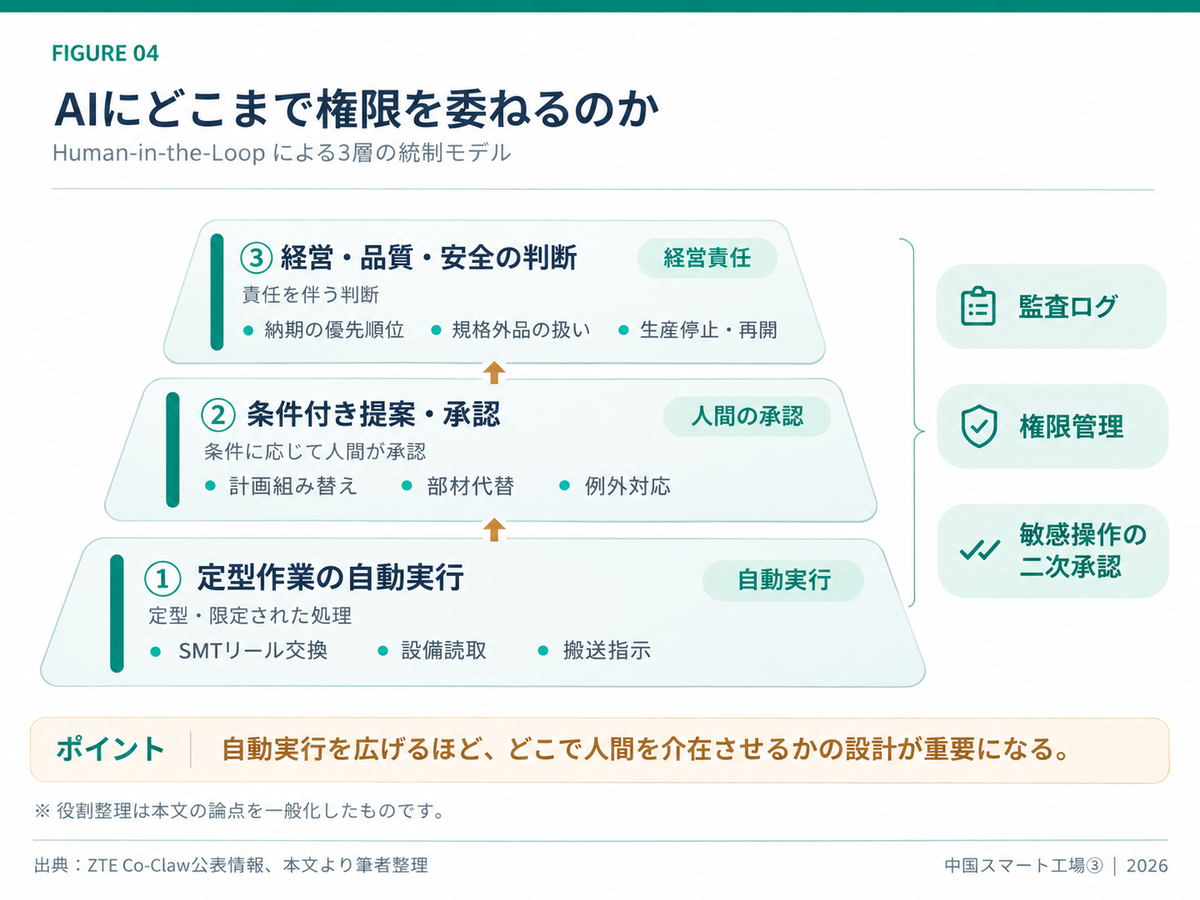
ここでは、Human-in-the-Loopという考え方が参考になります。人間がすべての操作を手動で行うことでも、AIがすべてを無条件で実行することでもありません。

事前に決めた条件で自動実行してよい範囲と、人間の確認・承認が必要な範囲を分ける設計です。

例えば、交換対象が確認でき、安全条件を満たすSMTリール交換は、自動実行と相性のよい仕事でしょう。定めた範囲内での構内搬送指示や設備点検も、一定の条件下なら自動化を考えられます。

しかし、重要顧客の納期を遅らせて別の顧客を優先する判断、検査に不安が残る製品を出荷する判断、最低限維持すべき安全在庫を割り込んで生産を続ける判断はどうでしょうか。

会社の契約、品質責任、リスク許容度に関わるため、単なる計算結果だけで決めるべきではない場合があります。

私なら、少なくとも次の三つの段階を分けて設計します。

第一に、定型作業の自動実行です。対象と条件が明確で、誤操作時に安全に停止・復旧できるもの。例えば設備状態の読み取り、決められた補充、定型の搬送などです。

第二に、条件付きの提案・承認です。計画を組み替える、部材の代替候補を提案する、外注や残業を追加するなど、費用や関係部門に影響する処理です。

AIは選択肢と影響を示し、権限者が確認してから実行します。

第三に、経営・品質・安全の判断です。重要な納期約束の変更、規格外品の取り扱い、重大な設備停止、顧客影響を伴う例外などは、誰が決裁し、どこまでのリスクを許容するかを組織として定める必要があります。

これらの境界は、企業や工程、リスクによって変わります。上の分類はZTE南京の内部承認ルールを再現したものではありません。

ZTEはCo-Clawの公式発表で、権限の強い管理、操作の追跡、安全上の制約、敏感な操作への段階的な対応といった考え方を説明しています。[5]

同社のAI一体機に関する発表では、重要システムの変更や資金移動などの敏感な操作に人間の二次確認を求める例も示しています。[8]

これは製品の一般的な安全設計の説明であり、南京工場で上記三段階がそのまま採用されているという意味ではありません。

自動化が進むほど、記録の重要性も増します。AIがいつ、どのデータを読み、どの規則で候補を選び、誰が承認し、何を実行したか。問題が起きたときにこの経緯が追えなければ、改善も説明責任も難しくなります。

また、過去の担当者が行っていた判断をそのままAIへ覚えさせればよい、というわけでもありません。過去には部門間の力関係や一時的な事情で決まった例外処理が含まれているかもしれません。

それを合理的なルールとして固定すれば、判断の速さだけが上がってしまいます。

AIへ権限を渡す前に、その業務ルールが現在の顧客条件や品質要求に照らして妥当なのかを見直す必要があります。私は、これも人間が担う重要な仕事だと思います。

まとめ――自律化する工場に必要なもの

ZTE南京濱江工場の取り組みは、設備や物流をデジタルにつなぐところから始まり、工業大規模モデル、数理最適化、AIエージェントによる判断・実行の連携へ進んできました。

2026年の80超という配備数は、その広がりを示す一つの数字です。

しかし、自律化とは、AIが人間に代わってすべてを決めることではないと思います。

正しいデータと業務ルールを整え、実行可能な計画を求め、決められた範囲では迅速に処理する。一方、何を優先し、どの例外を認め、誰が承認し、結果をどう検証するかは、組織として決めなければなりません。

工場の自律化で問われるのは、AIにどこまで判断させるかだけではなく、判断の根拠と責任をどこまで明確にできるかだと思います。

次回は、瀘州老窖の伝統醸造と、南通中遠海運川崎の造船を取り上げます。工場の判断を自律化するには、そもそも熟練者が何を見て、何を判断していたのかを理解する必要があります。

その知識をどう残し、製造精度や品質へ結び付けるのかを考えます。

今回はここまでとします。 最後までお読みいただき、ありがとうございました。

参考資料

[1] 中国工業情報化部「关于2026年度领航级智能工厂项目培育名单的公示」(2026年10月26日、公示期間10月27日〜11月2日)。 https://wap.miit.gov.cn/zwgk/wjgs/art/2026/art_9f8bf509706f4905aaa1cbcb4110892a.html

[2] ZTE「中兴通讯:“连接+算力”驱动增长……」(2026年10月26日)。南京濱江工場に80超のAIエージェントを配備したとの企業発表。 https://www.zte.com.cn/china/about/news/20261026C1.html

[3] ZTE「引领工业智能发展:国内首个五星5G工厂智能进阶实践」(2024年11月4日)。三段階の発展計画、生産計画、最適化手法と改善値。 https://www.zte.com.cn/china/about/magazine/zte-technologies/20230/10-cn/4/13.html

[4] ZTE「中兴南京滨江工厂再获殊荣,入选工信部‘卓越级智能工厂’」(2025年9月19日)。卓越級選定、工場自動化率、改善実績。 https://www.zte.com.cn/china/about/news/20250919C2.html

[5] ZTE「中兴通讯首发Co-Claw智慧园区方案……」(2026年4月1日)。南京濱江でのCo-Claw、現場物流、設備運用、セキュリティ統制。 https://www.zte.com.cn/china/about/news/20260401C1.html

[6] 南京市人民政府「国家领航级智能工厂,南京再+1」(2026年10月29日)。候補プロジェクト、SMT自動材料交換、製品不良率に関する記述。 https://www.nanjing.gov.cn/zgnjsjb/jrtt/202610/t20261029_6027754.html

[7] ZTE「中兴通讯董事长方榕:以智能体为引擎,共创数智新未来」(2026年4月15日)。生産計画期間80%短縮、部材充足注文の納品率29%改善など。 https://www.zte.com.cn/china/about/news/20260415C1.html

[8] ZTE OpenLab「中兴通讯正式发布Co-Claw AI一体机」(2026年4月)。敏感な操作への二次承認など製品の一般的な統制設計。 https://openlab.zte.com.cn/zh-CN/news/2026/4/ZTE-officially-releases-the-Co-Claw-AI-all-in-one-computer

※本稿は2026年11月1日までに確認した公開資料に基づきます。2026年度の領航級は公示段階の育成候補であり、正式認定やすべての育成目標の達成を意味しません。本文で引用した改善率・導入数は企業や政府記事に掲載された数値であり、第三者によるすべての測定条件の独立検証を示すものではありません。仮想的な業務例・統制モデル・筆者の考察は、ZTE工場の内部運用を断定するものではありません。

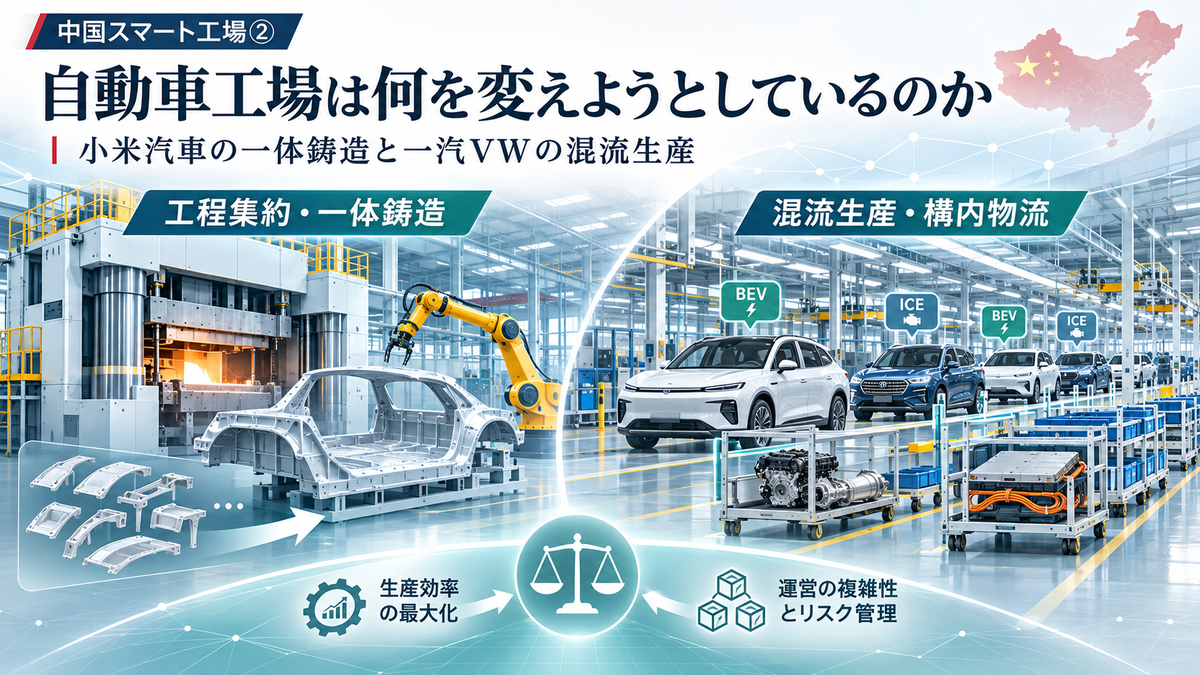
【中国スマート工場②】自動車工場は何を変えようとしているのか――小米汽車の一体鋳造と一汽VWの混流生産

同じ自動車工場でも、変えようとしているものは違う

皆さん、こんにちは。

車を速く、大量につくれる工場と、異なる車種を需要に合わせて柔軟につくれる工場。どちらが優れたスマート工場なのでしょうか。

一つの製品を安定して大量生産できるなら、工程をできるだけ集約し、設備を高い稼働率で動かすことには合理性があります。一方、車種や動力方式が変わり続ける市場では、必要なものを必要な組み合わせで生産できる柔軟性が欠かせません。ただし、速さを求めれば停止時の影響が大きくなる場合があり、柔軟性を高めれば計画や部材供給が複雑になる場合もあります。

2026年10月26日、中国工業情報化部が公示した「領航級智能工廠」の育成候補34件には、小米汽車と一汽フォルクスワーゲン(一汽VW)が含まれています。小米汽車のプロジェクト名は「AI駆動の機敏な高級新エネルギー車製造スーパー・スマート工場」、一汽VWは「燃油車と電動車の融合を目指す多車種混流・機敏な製造の母工場」と訳せる名称です。[1]

第1回では、中国が最先端の工場を評価する際、AIの導入状況だけでなく、生産効率、品質、在庫、納期、コスト、さらには他工場への展開も参考KPIに挙げていることを確認しました。今回は、その物差しを現場へ持っていきます。

ただし、今回の34件はあくまで育成候補です。公示されたプロジェクト名に書かれた方向性、すでに導入された設備、企業が発表した改善値、将来の計画を混同せずに見ていきたいと思います。

なぜ、小米汽車と一汽VWを比較するのか

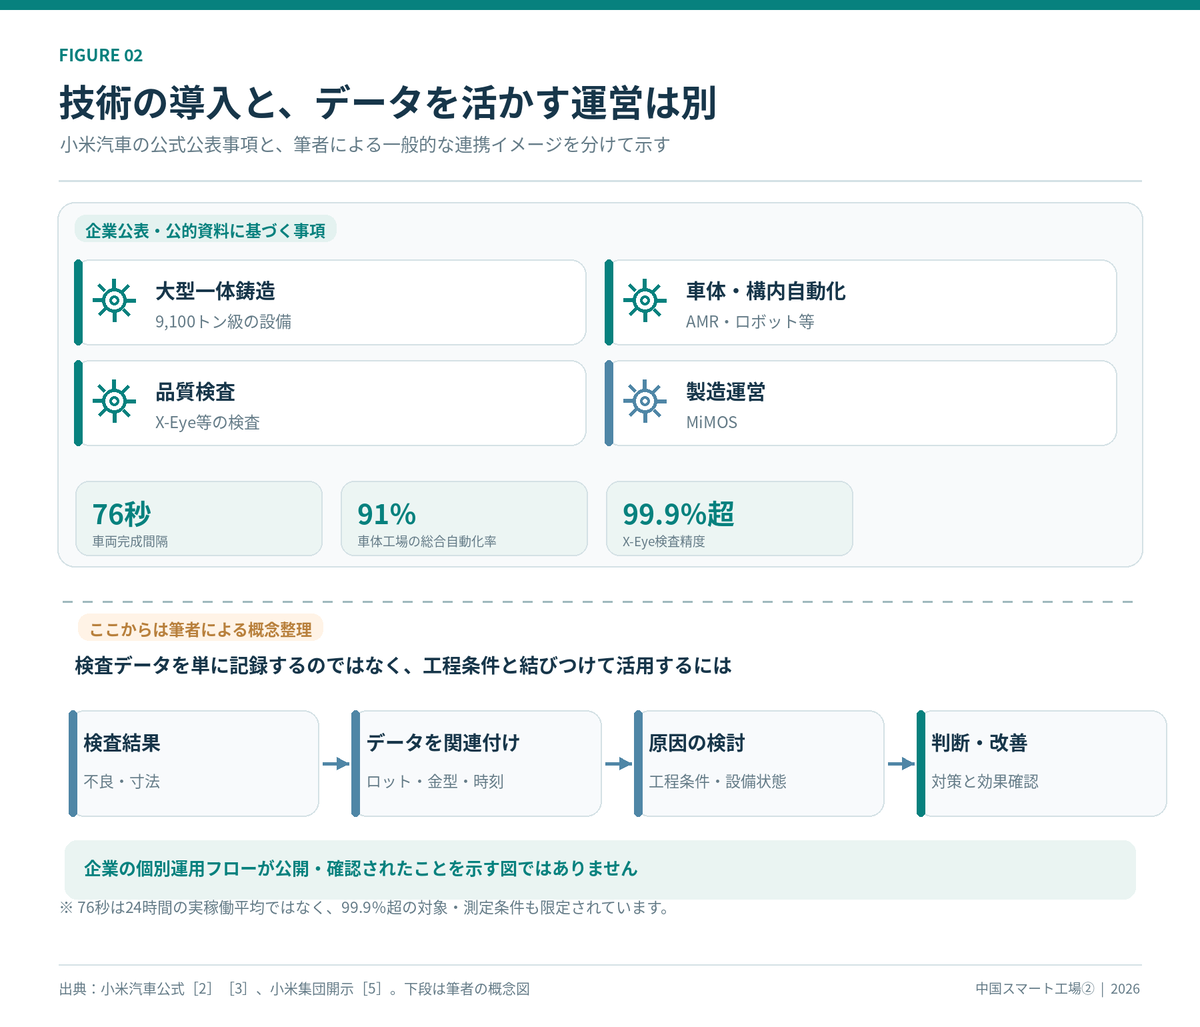
小米汽車は、スマートフォンなどで知られる小米集団が、自動車事業の立ち上げに合わせて新しい製造システムを構築した事例です。北京の工場には、プレス、大型鋳造、車体、塗装、電池、最終組立という六つの主要工程が配置されています。公式紹介によれば、700台超のロボットを採用し、車体工場の総合自動化率は91%とされています。[2]

一方の一汽VWは、1991年設立の自動車合弁企業です。長春をはじめ複数の生産拠点を持ち、既存の設備、部品供給網、品質管理、作業標準を積み重ねてきました。公式サイトによると、長春拠点では複数のフォルクスワーゲン車とアウディ車を製造しています。[6]

一方は、新しい工場を建設する段階から工程の統合を設計できる企業。もう一方は、既存の生産能力を使いながら、多様化する製品戦略へ対応しなければならない企業です。

この違いは、単に新興メーカーと老舗メーカーの違いではありません。新しい技術に合わせて工程を設計するのか、既存の工程に新しい技術や製品をどう組み込むのかという、投資の出発点の違いです。

新工場で採用できた生産方式が既存工場でそのまま有利になるとは限らず、逆も同じです。今回の比較では、どちらが何を得ようとし、その代わり何を管理しなければならなくなるのかを考えます。

小米汽車――工程を集約することの光と影

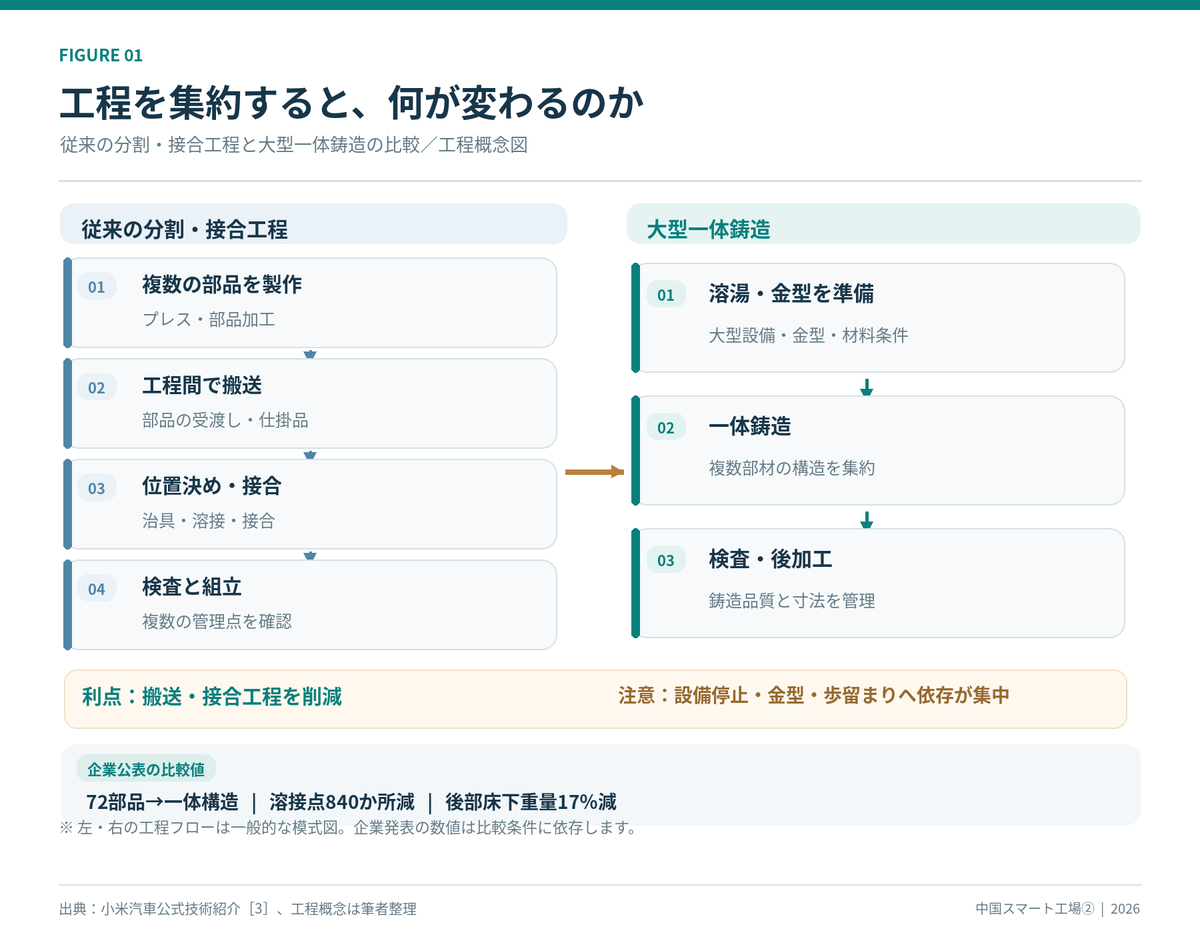
小米汽車を象徴する設備の一つが、9,100トンの型締力を持つ大型一体鋳造設備です。公式資料によれば、設備群は多数の周辺機器と工程管理を組み合わせたもので、同社は後部床下構造を従来の多数の部材から一体構造へ変更したことを紹介しています。[3]

自動車の車体は通常、複数のプレス部品を溶接や接合で組み立てます。大型一体鋳造では、その一部を大きなアルミニウム鋳造部品に置き換えます。「72部品を一つに」という同社の説明は、そうした工程集約を象徴する表現です。小米は、従来の板金製後部床下構造との比較として、溶接点840か所の削減、重量17%の削減を公表しています。いずれも小米の条件による比較値であり、車両全体の削減率を意味しません。[3]

ここで減るのは、部品点数だけではないはずです。個々の部品を運ぶ回数、溶接治具を用意する工程、位置合わせや接合の管理点、仕掛品を置く場所も変わります。生産技術の観点では、構造部品の設計変更が、加工・物流・検査・工程編成まで波及することに意味があります。

北京市政府の2026年10月の記事は、小米からの情報として、9,100トン級の設備群により関連部品の生産工数が従来のプレス工程より45%減少したと紹介しています。[4] ただし、どの工程のどの工数を比較した数字なのか、投資償却や設備保全費を含む総原価が何%下がったのかまでは、この数値だけでは分かりません。

工程を減らせば、停止リスクも減るのか

ここからは、一体鋳造技術一般に伴う製造・経営上の論点です。小米工場で実際に問題が起きているという意味ではありません。

複数の工程を一つに集約すると、中間の搬送や接合の負担を減らせる一方、その工程が止まったときの影響は大きくなり得ます。大型鋳造設備や巨大な金型の保全が計画どおりに進まなければ、後工程に渡す主要部品の供給が滞ります。代替となる設備や外部調達先を用意するにも、同じ品質と能力を満たす必要があります。

工場全体の稼働率を考えるとき、設備を高い速度で動かせることと、需要に応じて安定供給できることは別です。最大能力に余裕がなければ、突発停止後に遅れを取り戻す時間も限られます。逆に予備能力を厚く持てば、今度は投資効率が問題になります。

歩留まりも重要です。大型の鋳造品では、鋳巣、寸法変形、材料内部の状態など、鋳造特有の品質管理が必要です。問題が後工程で見つかれば、材料の回収・再溶解に加えて、投入した加工時間やエネルギーも無駄になります。鋳造材の再利用が可能であることと、不良の経済的損失が小さいことは同義ではありません。大型鋳造の工程・保全・修理に関する研究でも、金型寿命、検査、補修、サプライチェーンが主要な課題として挙げられています。[9][10]

大型部品を一体化した場合、事故修理時にどの範囲を交換するかという課題も生じます。小米は後部床下構造に取り外し可能な衝撃吸収領域を設けた設計を紹介しています。[3] これは一体化の不利を設計で緩和しようとする例として興味深いものの、あらゆる損傷について修理費が小さくなるという証明ではありません。

結局、工程集約は「部品点数が減る」という一つの指標だけで評価できません。設備の停止確率と復旧時間、金型の更新費、良品率、エネルギー、保全能力、補修の容易さまで含めて初めて、合理的な選択かどうかを判断できます。

工程を集約するほど、管理すべきリスクが消えるのではなく、集約先へ移ることがある。 私はそこを見落としたくありません。

小米汽車――工程をつなぐデータと品質管理

大型設備を導入するだけでスマート工場が完成するわけではありません。重要になるのは、設備が出すデータをどう読み、どの業務の判断につなげるかです。

小米の工場紹介によると、車体工場にはAMR(自律搬送ロボット)などを用いた部品供給や組付けの自動化が導入されています。塗装工程では色の切り替えに40分という数値を掲げ、検査では鋳造後部床下部品のレーザーレーダーによるオンライン検査、車体外観の自動検査、AIモデルを使った「X-Eye」などを紹介しています。[2]

X-Eyeの検査精度99.9%超という数値は小米の公表値です。対象とした不良種別、母集団、見逃しと誤検出の内訳が分からなければ、品質保証全体の達成率と同じ意味にはできません。また、X-Eyeという名称だけからX線検査装置だと解釈するのも避けるべきです。鋳造部品の内部欠陥を調べる非破壊検査と、外観・組付け状態を判定するAI検査は目的が異なります。

小米集団の公式開示は、工場の製造運営システム「MiMOS(Mi Manufacturing Operations System)」について、業務プロセス、データ、ユーザー需要を結び付け、ルールモデルと意思決定モデルを柔軟に組み合わせられる仕組みと説明しています。また同資料には、SU7が76秒ごとに完成するという工場の生産間隔が示されています。[5]

ただし、76秒という紹介値を、一日24時間を通じた実際の平均完成間隔と扱うことはできません。稼働時間、停止、車種構成、保全などの条件をそろえなければ、年間の実生産台数や総合設備効率を推計する根拠にはならないためです。

ここで考えたいのは、MiMOSの具体的な機能を過大に想像することではありません。公開資料から業務・データ連携の思想は読み取れますが、検査で見つかった不良がどのルールで生産計画へ反映され、誰が最終判断するかという個別の運用フローまでは確認できません。

一般論として、検査データが工程条件や設備状態と結び付けば、異常を検出するだけでなく、発生源をさかのぼって対策する可能性が広がります。ただし、そのためには部品番号、ロット、金型、製造時刻、不良分類などの定義をそろえなければなりません。「自動で検査できること」と「検査結果を経営成果へ変えられること」は、別の能力です。

第1回の参考KPIに照らせば、小米の事例では設備利用率、生産効率、不良率などが重要になります。ただし、そのすべてについて小米の改善実績が公開・検証されていると主張するわけではありません。

一汽VW――燃油車と電動車をどう共存させるか

もう一方の一汽VWは、製品の変化にどう対応するかという問題を示しています。

中国の自動車市場では、燃油車だけでなく、電気自動車、プラグインハイブリッド車、レンジエクステンダー式など、多様な動力方式が競合しています。一汽VWを含むフォルクスワーゲン側は、2025年3月の公式発表で、2026年以降に一汽VWのフォルクスワーゲン・捷達ブランドで11車種を追加する計画を公表しました。新型車には純電動車6車種、プラグインハイブリッド車2車種、レンジエクステンダー式2車種などが含まれます。[6]

また、2025年7月に発表された長春市と中国第一汽車の協力に関する報道では、一汽VWの長春拠点に新しいプラットフォームを採用した新エネルギー車4車種を投入し、2027年以降に順次生産する計画が説明されています。[8]

ここで、三つの段階を分けなければなりません。第一に、企業が異なる動力方式の車を商品として販売すること。第二に、それらを同じ生産拠点で製造すること。第三に、異なる車種・動力方式を同じ組立ラインで混流生産することです。

今回の育成候補プロジェクト名には「油電混共融」「多車種混流」が掲げられています。しかし、それだけで長春のどのラインにICE(内燃機関車)、HEV(ハイブリッド車)、BEV(電気自動車)が投入され、現在どこまで同一ラインで生産されているかを確定することはできません。一汽VWの公式工場紹介が示す既存車種と、今後の長春での新車投入計画も分けて扱う必要があります。[1][7][8]

したがって本記事では、一汽VWの公示上の目指す方向性を確認したうえで、混流生産が一般に抱える経営・物流上の課題を検討します。個別工場の未公表の能力を推定するためではありません。

既存の自動車工場には、車体、塗装、組立のラインだけでなく、長年構築した治具、品質保証基準、技能、仕入先との供給体制があります。電動化のたびにすべての設備を更新すれば、投資負担は大きくなります。かといって、既存設備を残すことだけを優先すると、新しい車種の設計自由度や生産効率を制約するかもしれません。

車体や塗装の共通化、最終組立の分岐、専用工程の設置など、どこを共通化しどこを分けるかが経営判断になります。混流が最適な工程もあれば、専用ラインが合理的な工程もあるはずです。

混流生産の難しさは、ラインの外側にもある

混流生産というと、異なる車種が一列に並び、同じラインを流れていく光景を思い浮かべます。しかし、現場で難しいのは、組立ライン上の作業だけではありません。その車に必要な部品を、正しい順序で、正しい場所へ届け続けることです。

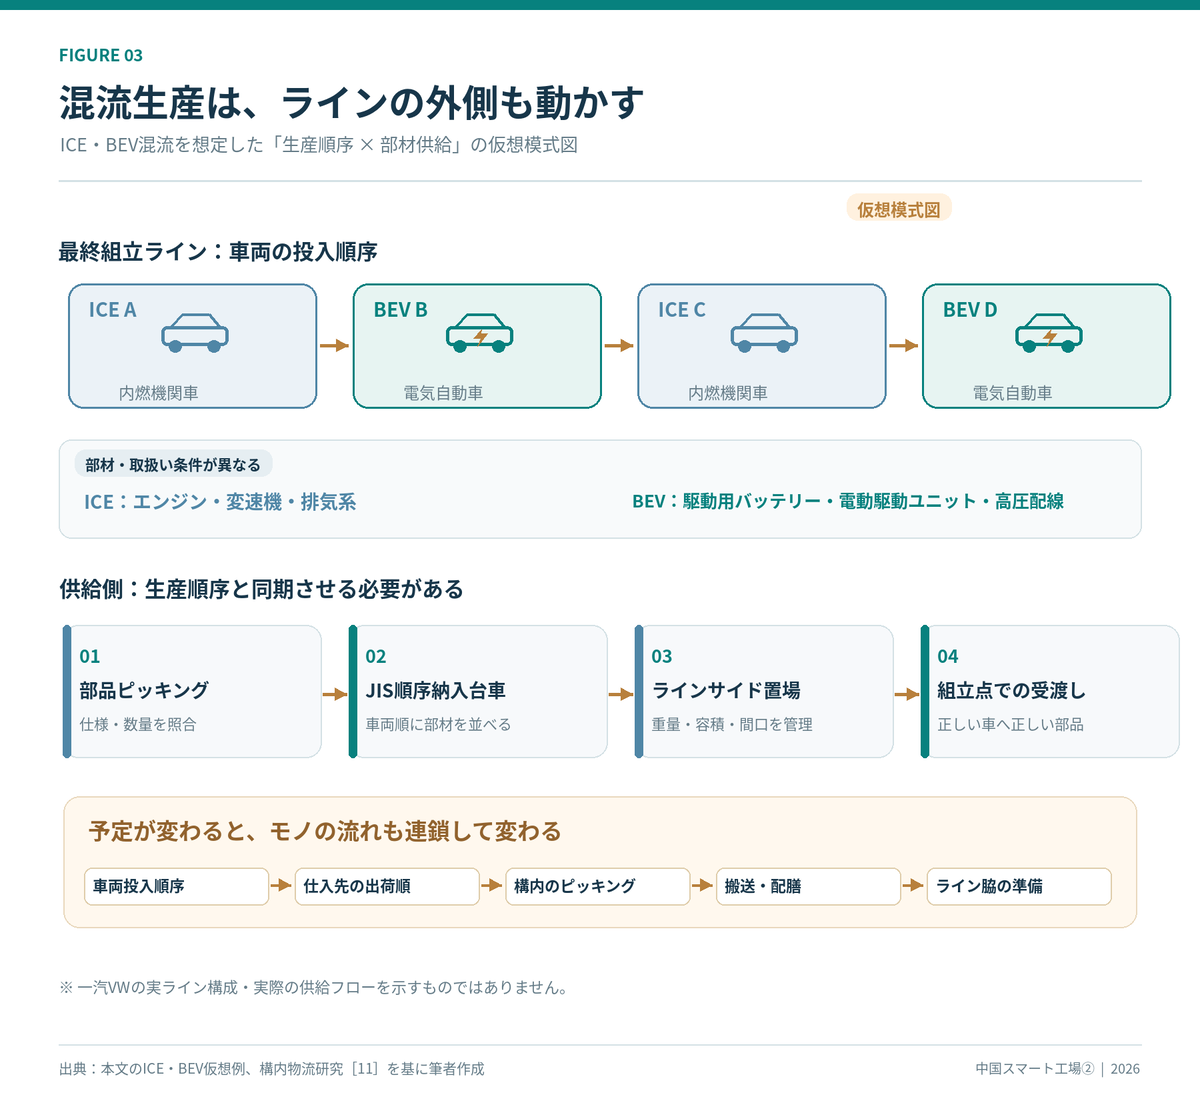
ここで、説明のための仮想的な工場を考えてみます。燃油車と電気自動車を同じ最終組立ラインで生産できるとしましょう。燃油車側ではエンジン、変速機、排気系の部材が必要になります。一方、BEVでは大型の駆動用バッテリー、電動駆動ユニット、高電圧配線など、部材の形状・重量・取扱い条件が大きく異なります。実際の製造工程では専用サブラインや別の組付け場所を使うこともあるため、すべてが同じ工程で扱われると決めつけることはできません。

違いは部品表だけに現れるのではありません。バッテリーのような大型・重量物には搬送設備や安全な置場が必要です。小さな電子部品は種類や仕様が多く、取り違え防止が重要になります。特定車種にしか使わない部材を大量にライン脇へ置けば、作業スペースが圧迫されます。少量ずつ供給すれば、その分だけ搬送頻度やピッキングの負荷が増えるかもしれません。

こうしたときに使われる代表的な考え方が、JIT(Just in Time)とJIS(Just in Sequence)です。JITは必要なものを必要な時点に合わせて供給すること、JISは生産順序に合わせて部品や部品セットを並べて供給することに重点があります。JITとJISは同義ではなく、部品や供給地点の特性によって使い分けられます。

例えば、ラインに投入する順序が「燃油車A、BEV B、燃油車C、BEV D」だった場合、正しい車種の部品があっても、届ける順序が一つずれてしまえば組立現場では使えません。仕様違いの部品を避けるため照合を厳しくすれば、その確認時間をどの工程で吸収するかも問題になります。実際の混流生産の研究でも、作業ステーションの負荷平準化と部材使用量の平準化、部品のライン供給方法が別々ではなく相互に関係する課題として扱われています。[11]

さらに難しいのは、予定が変わったときです。品質上の確認や部品欠品で投入予定の車両を入れ替えれば、工場の生産順序だけでなく、仕入先で組まれた出荷順序、構内倉庫でのピッキング、搬送車両、ラインサイドの準備が連鎖して変わります。生産計画の画面で行を入れ替えるだけでは済みません。

一汽VWの公式沿革には、2024年2月に長春拠点で「E-lane³」プロジェクトの開始式が行われ、高密度自動保管技術と複雑な配車・調度ロジックを組み合わせる取り組みと説明されています。[7] これは同社が長春で構内物流の高度化を進めている既存の事実です。ただし、この物流システムが今回の「油電混共融」候補プロジェクトのどのラインを支えるか、あるいは混流効果を何%改善したかは、公式沿革の記述だけでは判断できません。

私はこの点に、混流生産の本質があると感じます。生産順序を柔軟に変えられることと、変更した順序に合わせて現場のモノの流れまで変えられることは違います。

部材の欠品を防ごうとしてラインサイド在庫を増やせば、スペースや棚卸しの負担が増えます。在庫を極端に減らせば、仕入先の変動や搬送遅延に弱くなるかもしれません。必要なのは、車種切替の自由度と、供給を守るためのバッファをどの位置にどれだけ持つかという設計です。

この章の仮想例は、特定の一汽VW工場で報告された問題を示すものではありません。製品が多様化した工場に共通する管理上の難しさを説明しています。

二つの生産方式を、経営判断から読み解く

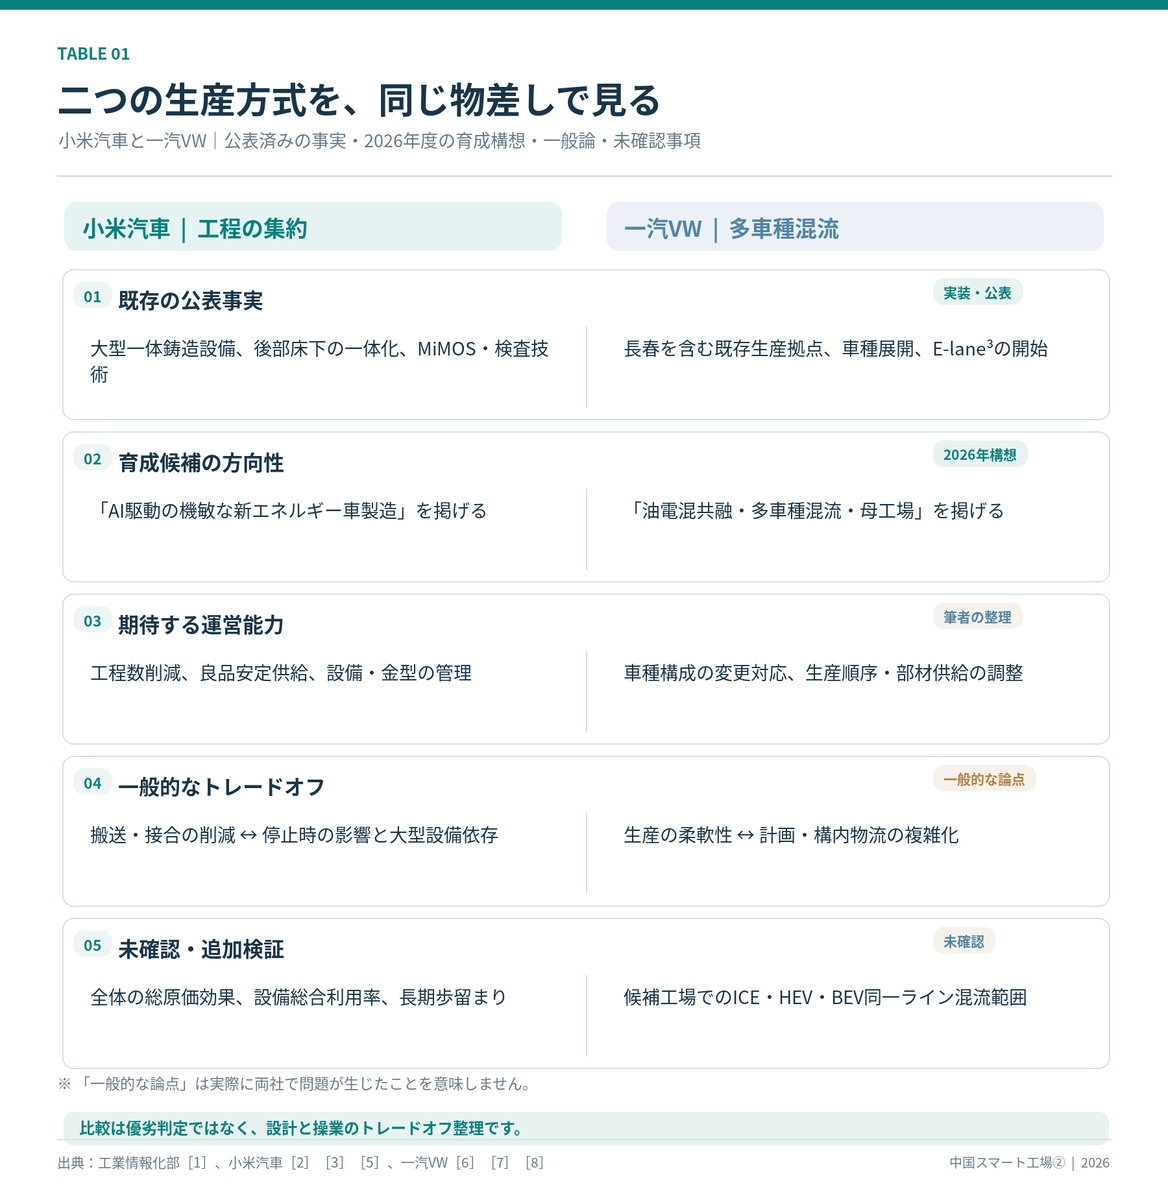
ここまでの内容を整理してみます。対比すべきなのは「最先端技術の数」ではなく、生産方式が変える費用とリスクの分布です。

小米汽車の工程集約では、部品を減らすことによって、搬送・接合・工程間調整を減らす可能性があります。その代わり、巨大設備・金型・材料・検査の管理に能力を集中させる必要があります。量産数量を確保できなければ大型投資の回収が難しくなる可能性もあります。

一汽VWの混流という方向性では、需要の変化や車種構成の変化に対応する自由度が期待できます。ただし、車種の違いを吸収するための工程・物流・品質保証・教育のコストが増える場合があります。既存ライン改造と新設ラインのどちらが合理的かは、車種構成や販売数量の見通しによって変わります。

重要なのは、「高い生産性」と「高い柔軟性」が常に対立するわけではないことです。工程集約によって得られた余力を品種切替に使うこともできれば、標準化によって混流ラインの生産性を上げることもできます。現実には、企業や工場ごとに、どの制約が最も重要かが異なります。

第1回の22の参考KPIから考えるなら、前者は生産効率や不良率、設備利用率、後者は納期遵守率、在庫回転率、生産効率などとの関係を確かめたいところです。しかし、公表資料で同じ条件による改善率が示されていない以上、両社のKPIを点数化し、「小米が上」「一汽VWが上」といった結論は出せません。

例えば、部品点数の削減を成果とするなら、総コストの内訳が改善したのかを確認したいと思います。混流対応車種数を成果とするなら、切替時の稼働率や納期がどう変化したのかが重要です。どちらも単独の「良い数字」だけでは十分ではありません。

工場の生産方式を評価するとは、改善の便益がどこに生まれ、コストやリスクがどこへ移ったのかを追うことではないでしょうか。

日系製造業は、何を選び、何を残すべきか

中国で大型一体鋳造が導入されているから、日本企業も同じ設備を導入すべきだ、とは思いません。一汽VWが多車種混流を掲げているから、あらゆる工場を混流化すべきだとも思いません。

大型一体鋳造は、製品構造と量産規模が合えば工程集約の有力な選択肢になり得ます。しかし、生産数量が少ない、製品変更が頻繁、設備保全の専門人材が限られるといった条件では、その投資が合理的とは限りません。一方、柔軟な設備を導入しても、部品供給・段取り・検査・人材育成が追い付かなければ、予定どおりに生産できない工場になるかもしれません。

設備投資の検討では、単純な導入金額だけでなく、私は少なくとも五つの条件を確認したいと思います。

第一に、製品と需要の見通しです。同じ工程を何年、どれだけの数量で使うのか。市場が変わったとき、設備や製品設計を変更できる余地はどれほどあるのか。

第二に、停止時の代替手段です。主要設備が故障したとき、修理にどれだけ時間が必要で、どこに余力を持てるのか。単に平均稼働率を上げるだけではなく、供給を守れるかどうかを確かめる必要があります。

第三に、品質をつくり込む能力です。完成品を検査して不良を見つけるだけでなく、どの工程条件を変えれば再発を減らせるかを理解できるか。データが残っていても、異常時に誰が判断するのかが決まっていなければ、現場は動けません。

第四に、工場内外の物流との整合性です。車種や仕様が増えたとき、仕入先、構内倉庫、ラインサイド、完成品の出荷まで、どこに在庫や時間の余裕を置くべきか。工場内の効率化が、仕入先の小口納入負担や緊急輸送費を増やしていないかも見たいところです。

第五に、その製造方法を組織の能力として残せるかです。設備メーカーや特定の熟練者がいなければ条件を変更できないとしたら、技術を導入しても十分な自社能力になったとは言えません。金型条件、工程の判断基準、供給順序のルール、例外対応、改善結果を、次の製品や別拠点でも使える形にできるでしょうか。

第1回では、AIの導入率や工場のランキングより、何を改善したかを見るべきだと述べました。今回の二社を通じて、その前にもう一つ問いがあると感じます。そもそも、何を改善するために、その生産方式を選んだのか。 その判断がなければ、KPIも設備も目的になってしまいます。

まとめ――速さと柔軟性の先にあるもの

小米汽車は大型一体鋳造によって工程の集約を進め、MiMOSや自動検査などの技術を公表しています。一汽VWは長年の生産基盤を持ちながら、燃油車と電動車の多様化に対応する製造方式を育成構想として掲げています。

一体鋳造には工程集約の利点と設備・品質管理への集中があります。混流生産には柔軟性への期待と、生産順序・部品供給・工程負荷の調整が伴います。どちらも、技術の名称だけでは成果を判断できません。

優れた工場をつくるうえで大切なのは、先進技術を選ぶことだけでなく、自社に合う生産方式を選び、その利点と制約を運営できることだと思います。

次回はZTE南京の工業AIエージェントを取り上げます。今回見たように、モノの流れを柔軟に変えようとするほど、その前提となる情報の流れと判断方法も変える必要があります。そのときAIは、どこまでを担えるのでしょうか。

今回はここまでとします。 最後までお読みいただき、ありがとうございました。

参考資料

[1] 中国工業情報化部「关于2026年度领航级智能工厂项目培育名单的公示」(2026年10月26日)。10月27日〜11月2日の公示時点の育成候補を対象としています。 https://www.miit.gov.cn/jgsj/zbys/znzz/art/2026/art_9b66cbd1acce49118fef59e698f40112.html

[2] 小米汽車「小米汽车工厂」(公式工場紹介)。工場構成、ロボット、車体工場の自動化率、品質検査、塗装など。 https://www.xiaomiev.com/hyperfactory

[3] 小米汽車「Xiaomi HyperCasting 小米超级大压铸」(公式技術紹介)。型締力、72部品の一体化、溶接点数・重量比較、材料・設計。 https://www.xiaomiev.com/hypercasting

[4] 北京市人民政府「北京项目首次入选领航级智能工厂培育名单」(2026年10月28日)。45%工数削減、工場概要等。数値の公表主体は小米汽車。 https://www.beijing.gov.cn/fuwu/lqfw/gggs/202610/t20261028_4921331.html

[5] 小米集団「小米汽车工厂」(企業公式開示資料)。MiMOS、76秒という車両完成間隔、2025年卓越級への選定等。 https://ir.mi.com/static-files/8ca09a6f-2cbc-45fd-a359-3b0f8fdc869a

[6] フォルクスワーゲングループ(中国)「大众汽车集团与中国一汽共谱合作新篇章…」(2025年3月18日)。一汽VW新型車計画。 https://volkswagengroupchina.com.cn/MediaCenter/News/Detail?itemid=C71DED14-28D3-469A-8FD9-2A836CD2E50F

[7] 一汽VW公式「品质之旅/长春基地」「发展历程」(2024年E-lane³開始、長春拠点の製造車種)。 https://www.faw-vw.com/industry-tourism https://www.faw-vw.com/development-journey?phase=4

[8] 長春市・中国第一汽車の協力合意を報じた人民財訊(2025年7月13日)、吉林省人民網(2025年7月12日)。長春への新エネルギー車投入計画。 https://www.stcn.com/article/detail/2544915.html https://jl.people.com.cn/n2/2025/0712/c349771-41289343.html

[9] Burggräf, P. et al., “Mega-casting in the automotive production system,” Journal of Manufacturing Processes, 124 (2024), 918–935. 大型鋳造の機会と課題を業界専門家への聞き取りから分析。 https://www.sciencedirect.com/science/article/pii/S152661252400608X

[10] Bleicher, C. et al., “Aspects for the Optimization of Car Production Regarding Efficiency, Availability and Sustainability,” SAE Technical Paper 2025-01-8609 (2025). 大型鋳造部品の生産・サプライチェーン・修理等の論点。 https://saemobilus.sae.org/papers/aspects-optimization-car-production-regarding-efficiency-availability-sustainability-2025-01-8609

[11] Ostermeier, F. et al., “Joint modelling of the order-dependent parts supply strategies sequencing, kitting and batch supply for assembly lines,” Production & Manufacturing Research, 11 (2023). 混流生産の部品供給方式と現場運用。 https://doi.org/10.1080/21693277.2023.2200808

※この記事は2026年11月1日までに確認できた公開情報を基にしています。工業情報化部の34件は正式認定ではなく、育成候補の公示です。小米の設備数・性能・改善値は企業または企業情報を引用した公的資料の公表値であり、全てが独立検証されたものではありません。一汽VWについても2026年度候補工場でのICE・HEV・BEVの具体的な同一ライン混流範囲は未確認です。文中の混流工程・構内物流・停止リスク等の仮想例は一般的な技術・管理上の考察で、両社で発生した問題を示すものではありません。

【中国スマート工場①】中国が選ぶ「最先端工場」とは何か――領航級育成候補34件と22の評価指標

ロボットの数では測れない、工場の競争力

皆さん、こんにちは。

「最先端のスマート工場」と聞いて、どんな工場を思い浮かべるでしょうか。

ロボットが整然と稼働する無人化ライン。カメラが不良品を見つけるAI検査。工場の稼働状況を映し出す大型モニター。どれもスマート工場を象徴する風景です。けれども、設備が新しく、AIの導入数が多ければ、それだけで優れた工場と言えるのでしょうか。

生産管理の立場から考えると、私は少し違う問いを持ちたくなります。AIを導入した結果、欠品は減ったのか。部材の在庫は適正化されたのか。約束した納期を守れるようになったのか。さらに、ある工場で生まれた改善を、別の工場や取引先でも再現できるのか。

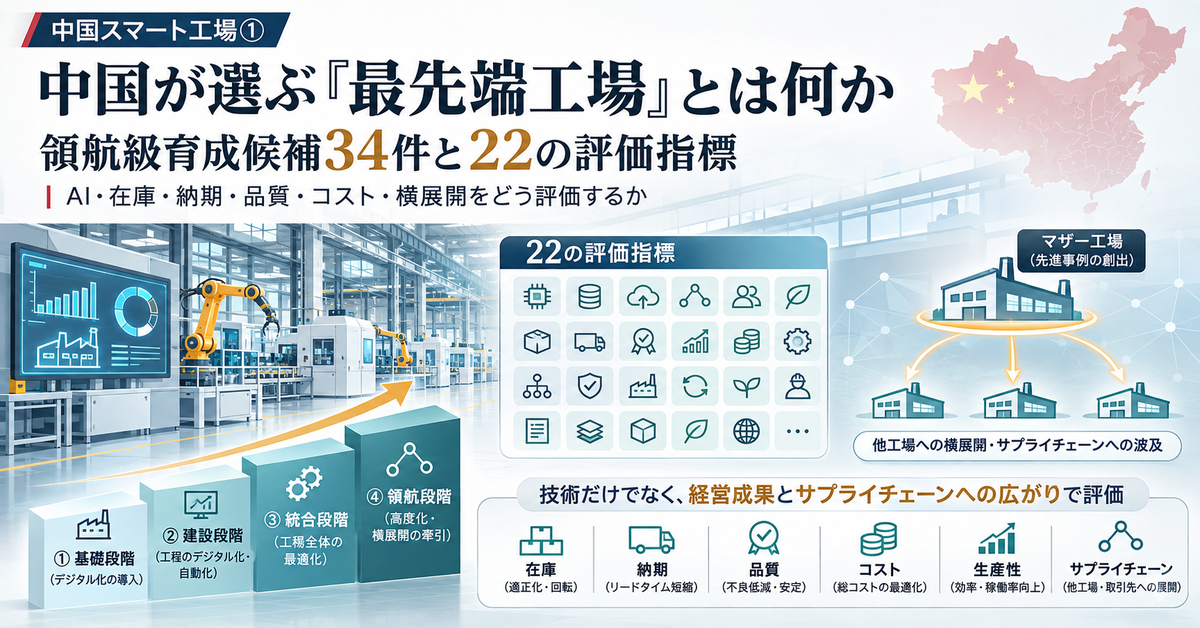
中国工業情報化部は2026年10月26日、「2026年度領航級智能工廠プロジェクト育成名簿」の候補34件を公示しました。小米汽車(シャオミの自動車事業)や中興通訊(ZTE)など、さまざまな業種の企業が名を連ねています。公示期間は10月27日から11月2日までです。[1]

ここで最初に区別しておきたいことがあります。公示された34件は、完成した工場に対する新たな「正式認定34件」ではありません。領航級の工場を育てるためのプロジェクト育成候補です。候補に挙がったことと、今後の目標をすべて達成したことは同義ではありません。 私が今回この中国の公示を取り上げる理由は、先進設備を持つ企業の名前を並べたいからではありません。国の育成制度が、AIの適用範囲だけでなく、在庫・納期・品質・コスト、さらには他企業への展開までを同じ参考指標の枠組みで示しているからです。技術の導入が目的になりがちな議論を、製造業の仕事と経営成果に引き戻す手掛かりがあると感じます。

11月7日の週末特別コラムでは、中国の国家標準GB/T 47859-2026を取り上げ、設備や工程の動作を、将来組み替えられるように設計する考え方を検討しました。今回は規格の技術的な説明を繰り返すのではなく、育成制度の側から工場を見てみます。中国は、スマート工場の何を評価し、どのような能力を産業全体へ広げようとしているのでしょうか。

その手掛かりになるのが、2026年版の育成要件と、そこに掲載された22項目の参考KPIです。[2][3]

中国はスマート工場を、なぜ4段階で育てるのか

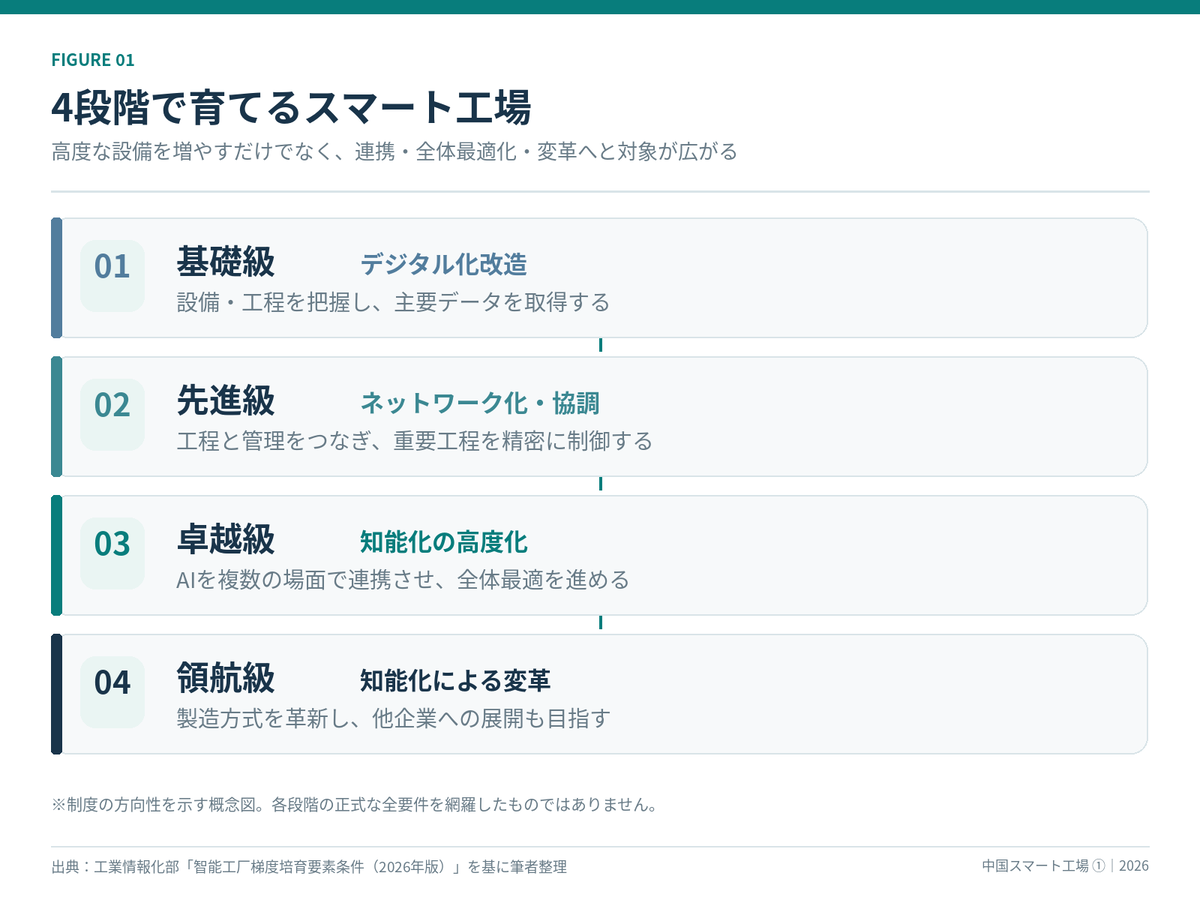
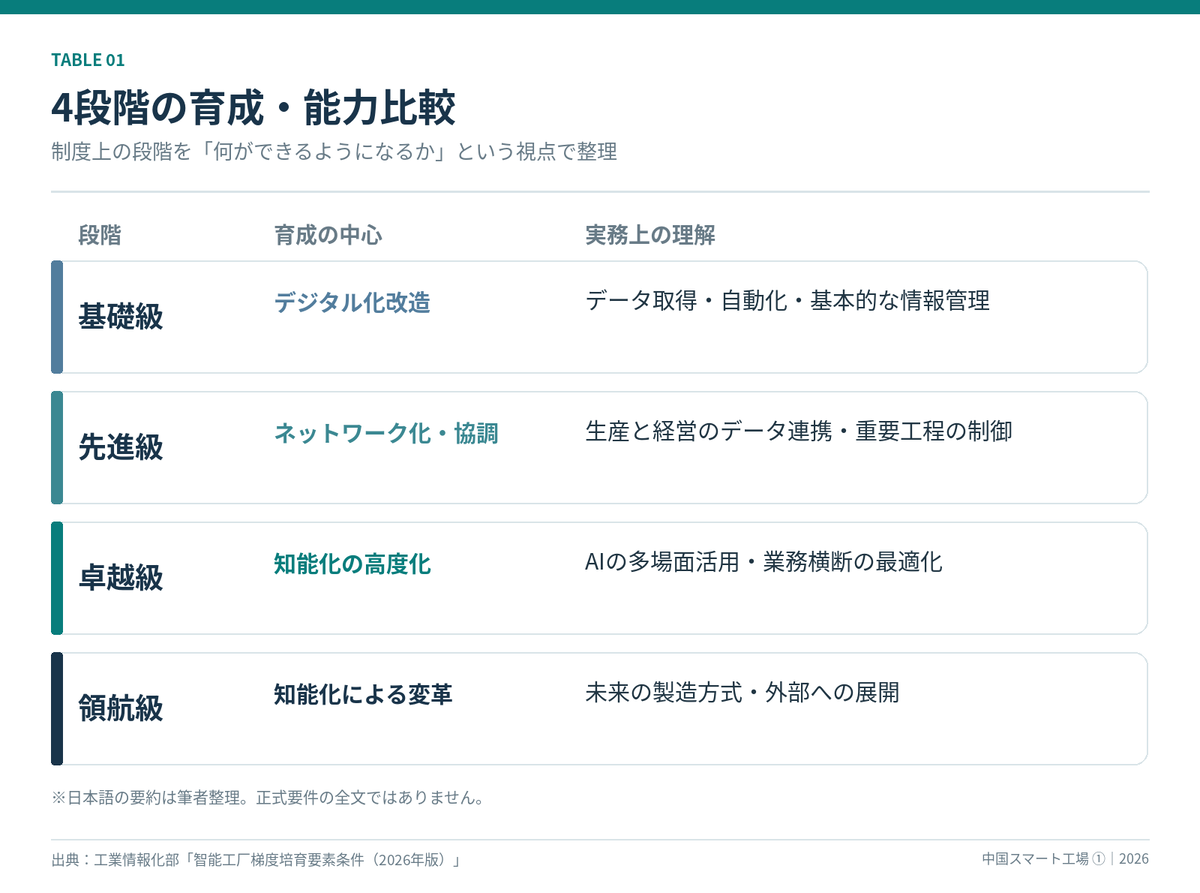
中国の2026年度のスマート工場育成制度は、「基礎級」「先進級」「卓越級」「領航級」の4段階です。名称だけを見ると、工場を成績順に並べるランキングのようにも感じられます。しかし実際には、それぞれに求める能力と育成の目的が異なります。[2][3]

例えば基礎級では、必要な設備・システムを導入し、重要工程のデータを把握できる状態が一つの出発点になります。先進級になると、部門・設備・システムの間で情報を連携させ、生産と経営の管理を結び付けることが求められます。

卓越級では、さらにAIの複数場面での協調的な利用、工場全体の最適化が中心となります。領航級が目指すのは、既存の仕事を少しずつ効率化するだけではありません。新しい製造プロセスや管理方法をつくり、他社にも展開できる水準へ高めることです。

2026年版の要件には、スマート製造能力成熟度について基礎級・先進級は2級以上、卓越級は3級以上、領航級は4級以上という条件もあります。さらに、領航級の申請主体には、既に卓越級の評価を受けた業界を代表する企業であることなどが求められます。[2][3]

つまり、上の段階に進めば単にロボットを増やせばよいわけではありません。工程の制御から業務の協調へ、個別最適から全体最適へ、そして工場内部の改善から外部への波及へと、取り組む範囲が広がっていきます。

もっとも、この4段階であらゆる工場の優劣が決まるわけではありません。多品種少量の専用機工場と、大量生産の完成車工場では、合理的な設備や改善方法は異なります。自社の事業に必要な能力と、制度の最上位で求められる能力は区別して考える必要があります。

AI適用場面比率30%・60%という数字をどう読むか

2026年版の育成要件には、特に目を引く数字があります。

卓越級は、AI技術を適用する場面の比率が30%以上。領航級では60%以上。いずれも「建設成果」の要件として示されています。[3]

この数字を見て、「領航級では工場の仕事の60%をAIが自動で行うのか」と考える方もいるかもしれません。しかし、その理解は正確ではありません。原文が示しているのは、AI技術を適用する場面の比率であり、全従業員の仕事時間の60%、設備の60%、あるいは工程の60%を無人化するという意味ではないからです。公表された数字だけでは、どの業務を一つの場面として数え、何を母数としたのかも判断できません。

AIの適用範囲を考えるとき、品質検査だけを見ても十分ではありません。需要予測、生産計画、設備保全、倉庫内の搬送、部材調達、エネルギー管理など、異なる業務にどのように組み込まれているかを確かめる必要があります。

例えば品質検査にAIを導入し、不良品の見逃しを減らした工場があるとします。それ自体に価値はあります。しかし、検査で得たデータが製造条件の見直しや設備保全計画に反映されなければ、改善は検査工程の中にとどまります。

一方、不良傾向を工程条件と結び付け、計画・保全・品質部門が共通のデータで判断できるようになれば、技術の効果はより大きくなり得ます。ただし、これは説明用の仮想例であり、候補34社の実績を示したものではありません。 ただ、部門を横断してAIを使おうとすると、ソフトウェアの導入だけでは済みません。例えば「納期」と言っても、工場の完成予定日、出荷日、顧客への着荷日では意味が異なります。品質データにも、検査の基準や不良分類が工場によって違う場合があります。まず何を同じ言葉として扱うかを、人が確認する必要があります。 現場で使われている例外処理や判断の優先順位を聞き取り、データ項目と業務ルールへ整理し、AIの提案を誰が検証するかまで決める。最先端の技術を実務の成果につなげる過程には、こうした地道な作業が残ります。これは特定の候補企業で確認した実装事実ではなく、日系工場でも起こり得る一般的な論点として挙げています。

大切なのは、60%という比率を高くすることそのものではなく、AIを適用した結果、製造・管理に何が変わったのかを確認することです。AIモデルの数やエージェントの数を数えるだけでは、経営上の成果を測ることはできません。

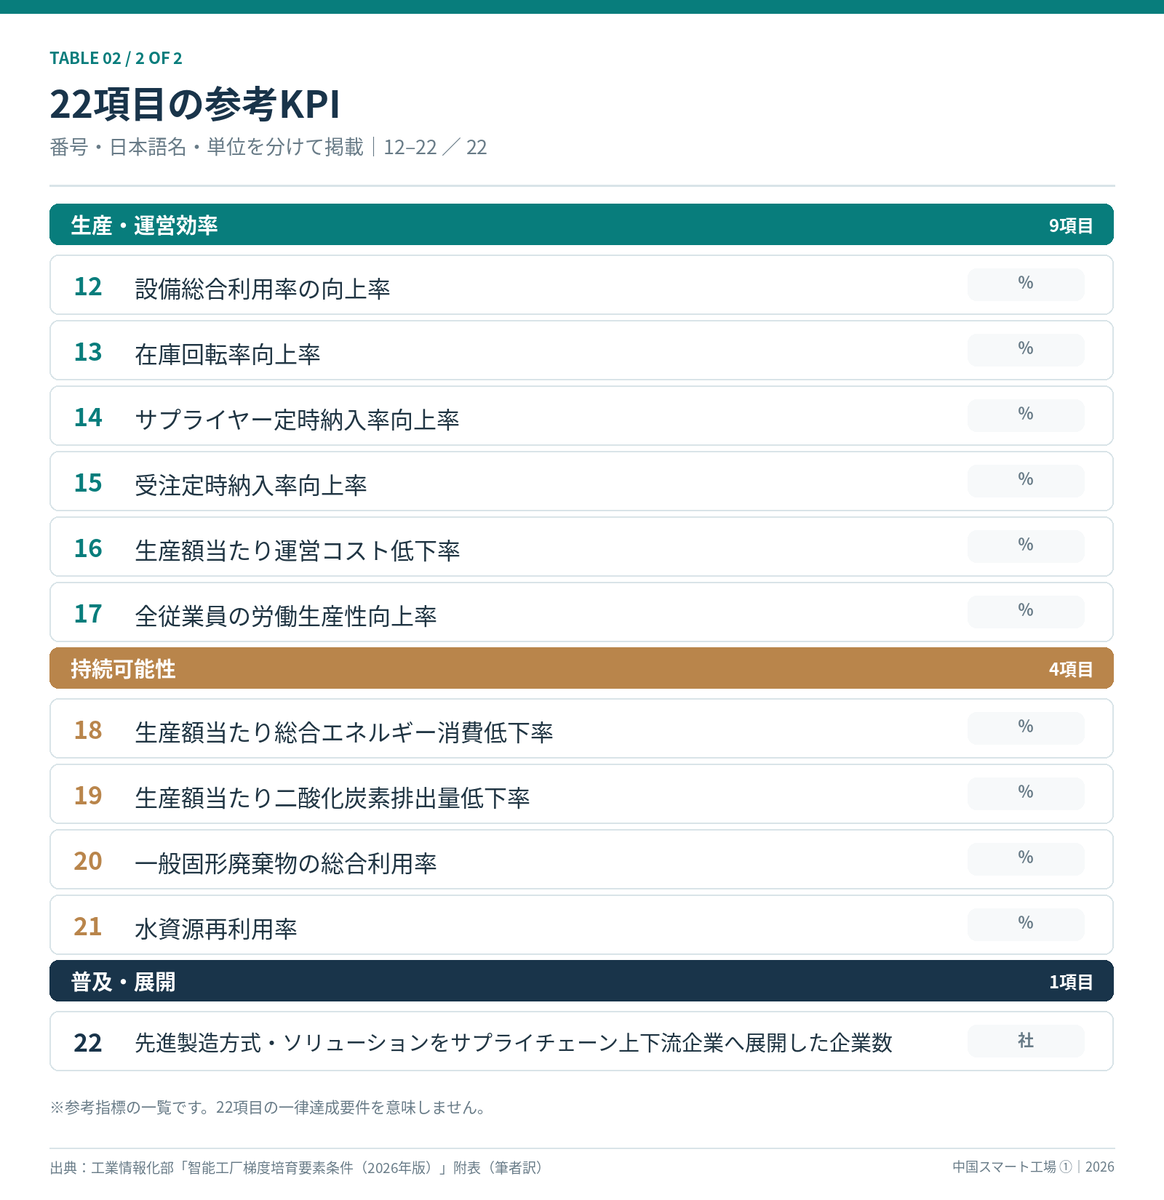
22の参考KPIに表れた、中国の評価思想

工場のDXについて報告を受けるとき、「システムを導入した」「AIによる検査を始めた」といった説明は分かりやすいものです。ただ、経営者が本来知りたいのは、その先のはずです。

生産性は改善したのか。設備は安定して稼働するようになったのか。在庫は滞留していないか。サプライヤーからの納入と、顧客への出荷は約束どおりに行われているのか。

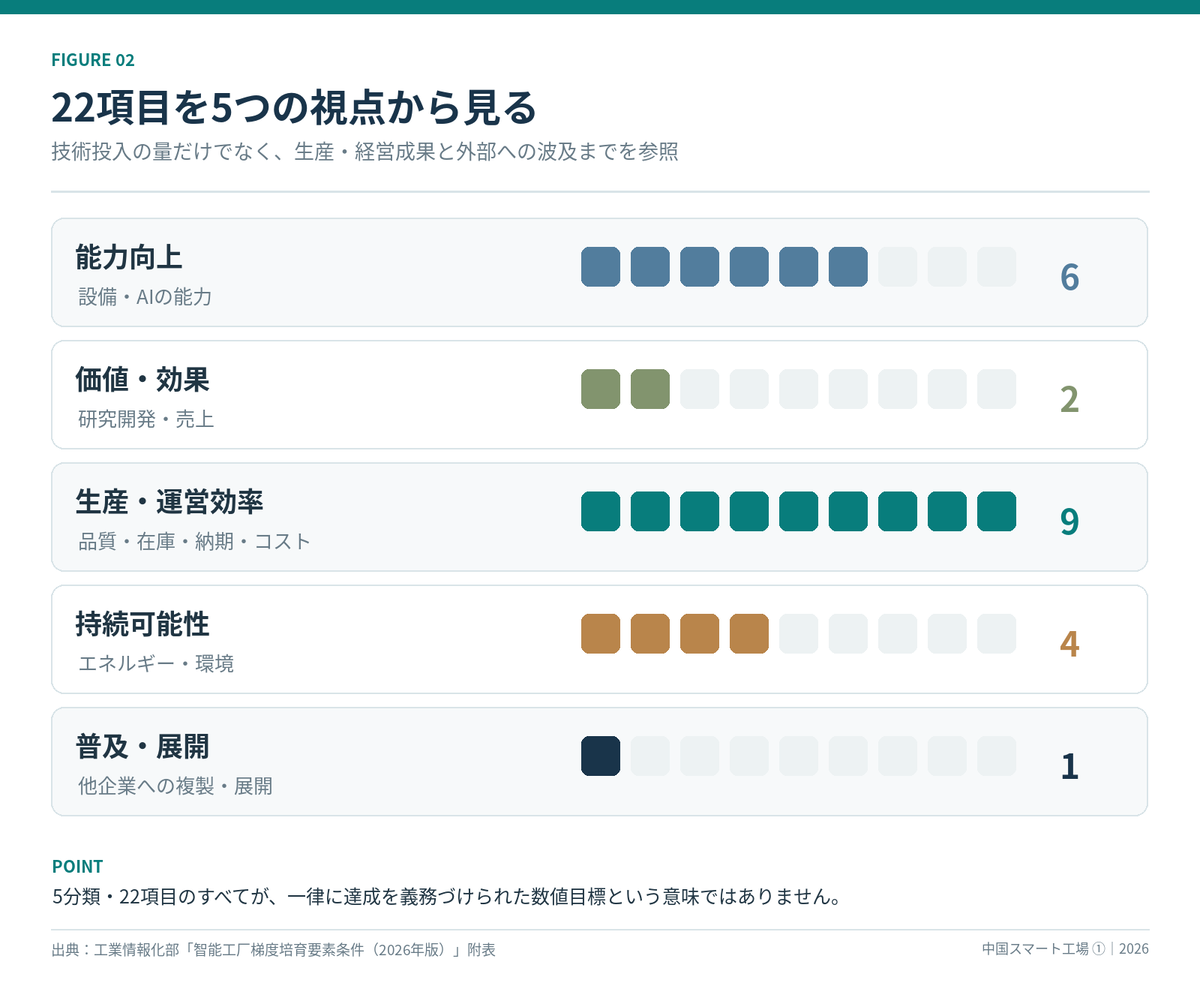
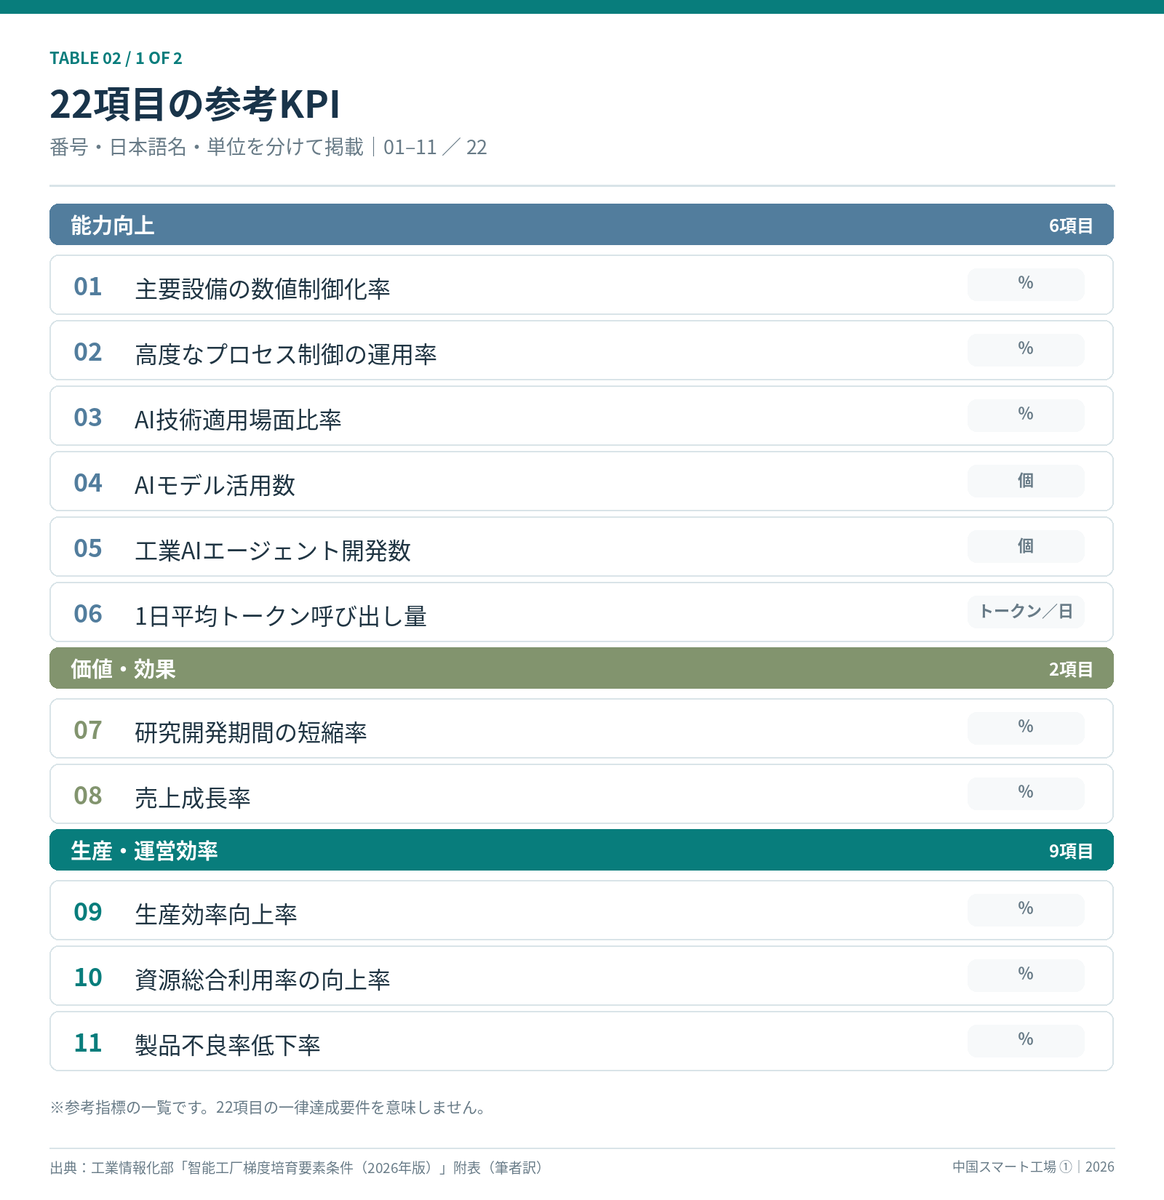
2026年版の附表「スマート工場建設の主要業績指標の参考」には、次の5分類・22項目が示されています。[3]

※日本語名は筆者による要約訳です。項目の定義、評価方法や数値の扱いは中国語原文を優先してください。また、この表は参考KPIであり、22項目それぞれに一律の合格点が決められているという意味ではありません。

「AIを使っている」と「仕事が良くなった」は別の評価である

初めの6項目には、設備の数値制御化率に加えて、AIモデル数、工業AIエージェント数、1日平均トークン使用量といった、技術や運用能力を示す数字が並びます。

これらはAIを工場へ組み込む能力を知るうえで参考になります。ただし、利用量が大きいからといって、良い意思決定をしていることにはなりません。モデルやエージェントを多数動かしても、同じデータの重複確認や不要な処理が増えているだけかもしれません。

一方、次の分類には研究開発期間や売上があり、さらに生産・運営効率の9項目には品質、在庫、納期、コスト、労働生産性が続きます。

この並びを眺めると、中国が設備やAIの導入状況を確認するだけでなく、それが具体的な事業成果へ転換されることを重視していると読み取れます。ただし、これは筆者による制度の解釈であり、指標を並べた順番が公式の因果関係を意味するわけではありません。

指標が「達成目標」に変わったとき

ここで気を付けたいのが、数字をよくする行動と、仕事をよくする行動は必ずしも一致しないことです。いわゆるグッドハートの法則は、測定指標を強く管理目標にすると、もともと測ろうとした実態との関係が崩れ得るという問題を示しています。[4] 例えば設備稼働率を最優先すれば、必要のない製品まで生産して在庫を増やすかもしれません。AIエージェントの数やトークン使用量を増やしても、現場の判断が速く正確になるとは限りません。指標が悪いのではなく、複数の指標と現場の実態を合わせて見なければ、改善の方向を取り違えるということです。これは今回の制度が数字合わせを促していると断定する話ではなく、制度を運用・参照する際の注意点です。

在庫回転率と納期遵守率を一緒に見る意味

私は、生産管理やSCMの実務に関係する13〜15番の指標に特に注目しています。

在庫回転率が高まれば、一般には在庫が効率よく売上や生産に結び付いている可能性があります。しかし、在庫を減らしただけでは、欠品が増え、顧客への納期遵守率が下がることもあります。逆に、欠品を恐れて大量の安全在庫を積めば、納期は守りやすくなっても資金や保管スペースを圧迫します。

そこで、在庫回転率、サプライヤー納期遵守率、受注納期遵守率を同じ議論の中で見ることに意味があります。三つの数字は別々の部門の成績表ではなく、互いに影響を与える一つの業務の結果だからです。

たとえば、新しい生産計画システムを導入して在庫回転率が改善したとしても、その間に緊急輸送が増えたり、仕入先への無理な納期変更が常態化したりしていないか。製造部門の効率だけを上げた結果、調達や物流へ負担を押し出していないか。こうした点まで確認しなければ、全体最適とは言えません。

もちろん、在庫回転率の向上は業種によって意味が違い、納期遵守率にも集計条件があります。受注生産と見込生産、長納期の大型設備と短サイクルの消費財を、同じ絶対値で比較するのは適切ではありません。制度の指標は、自社の改善を考える入口として使うのが実務的でしょう。

改善率を見るときに必要な「比較条件」

ここに並ぶ多くの指標は、向上率や低下率です。改善前の状態が分からなければ、その数字の重みは判断できません。

例えば不良率が半減したという発表があったとします。もとの不良率が2%だったのか、0.02%だったのかでは意味が変わります。生産量や製品構成、歩留まりの測定方法が違えば、改善効果の比較も難しくなります。単年度の好成績と、長期間安定して達成した成果も別です。

今回の候補企業を読む際にも、「導入した技術」「企業自身が発表した成果」「第三者が確認した成果」「今後の育成目標」を分ける必要があります。次回以降の企業分析では、この区別を共通の評価軸にします。

最後の1項目が示す、もう一つの目標

22項目の最後は、技術の導入率でも生産性でもありません。

先進的な製造方式やソリューションを、サプライチェーンの上下流にある何社へ展開したかという指標です。

この項目があることは興味深いと思います。自社工場で優れた成果を出すだけでなく、その能力を他企業へ移し、産業全体の製造水準を引き上げることを視野に入れているからです。

ただし、展開した企業数が多ければ必ず成功とは限りません。導入先で安定運用できているか、品質や納期が改善しているか、運用を担う人材が育っているかも重要です。母工場が作った仕組みを別の工場へ移す際には、現地の設備・人材・顧客条件に合わせる作業も必要になります。展開数は普及の広がりを示しても、再現の質をそれだけで証明するものではないと考えます。

育成候補34件を横に並べると、何が見えるのか

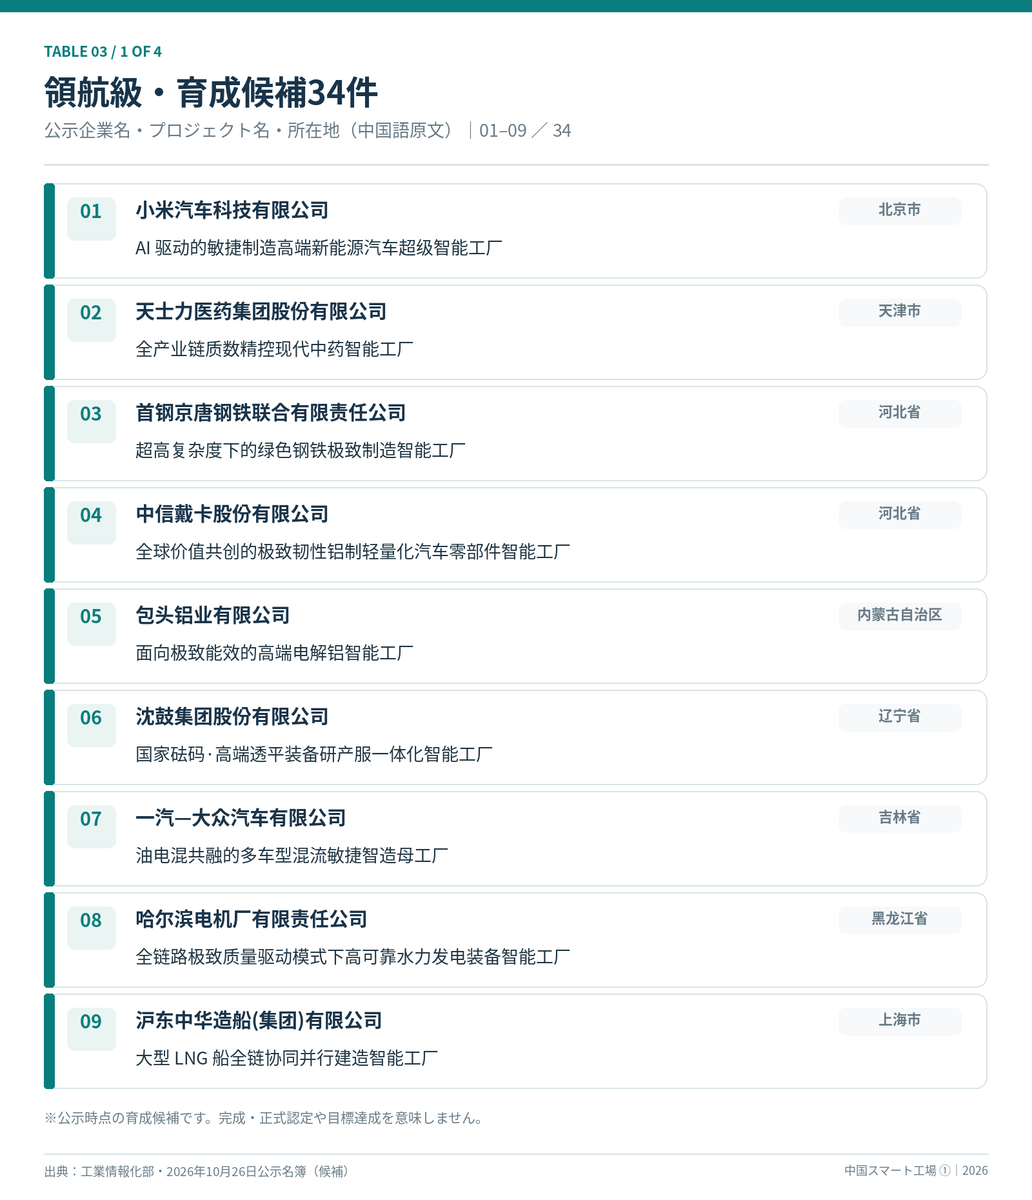
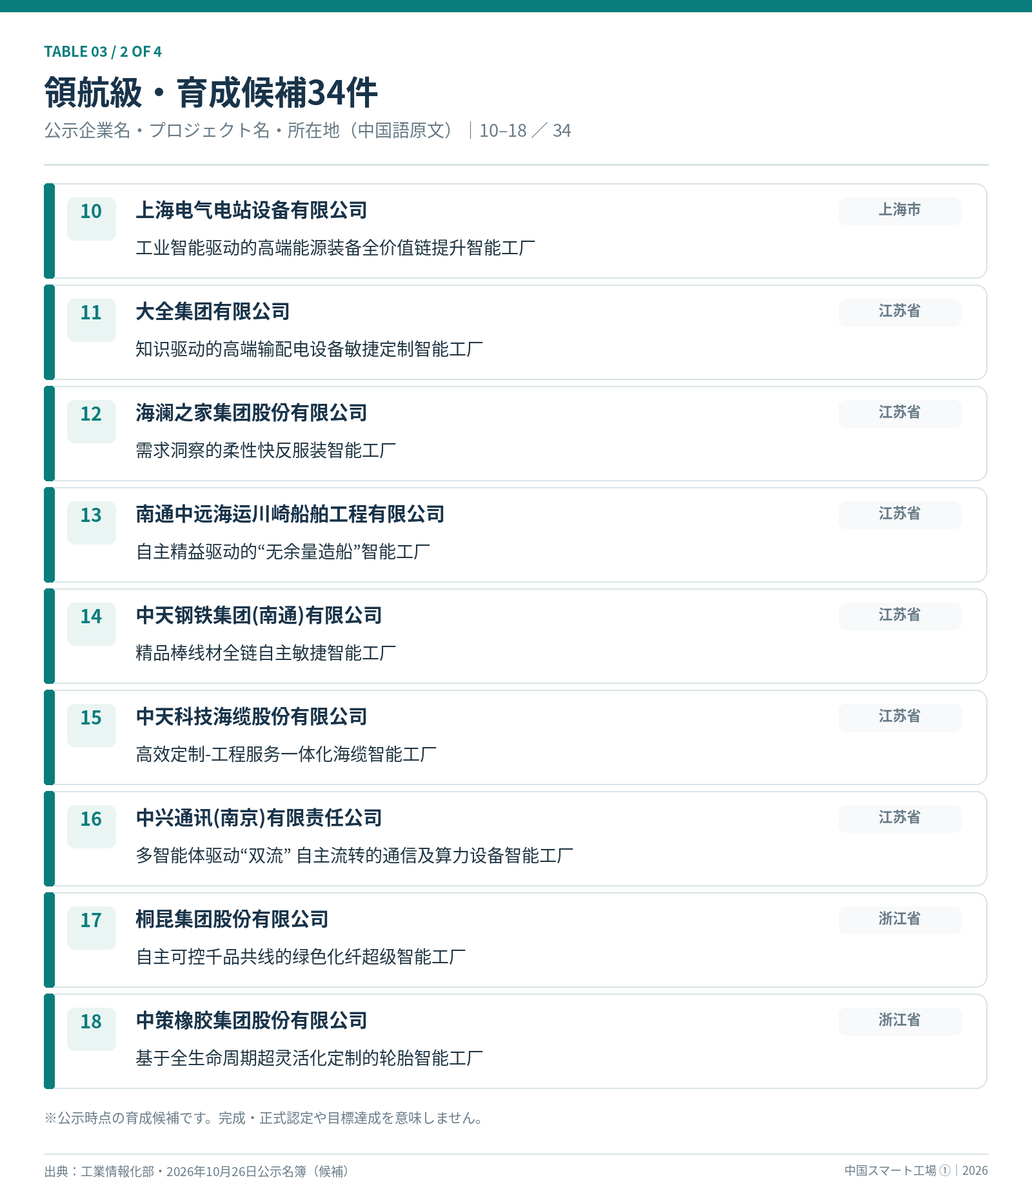
今回公示された34件は、完成車メーカーや通信機器メーカーだけではありません。鉄鋼、製錬、電力機器、造船、化学繊維、医薬品、衣料品、酒類製造まで含まれています。[1]

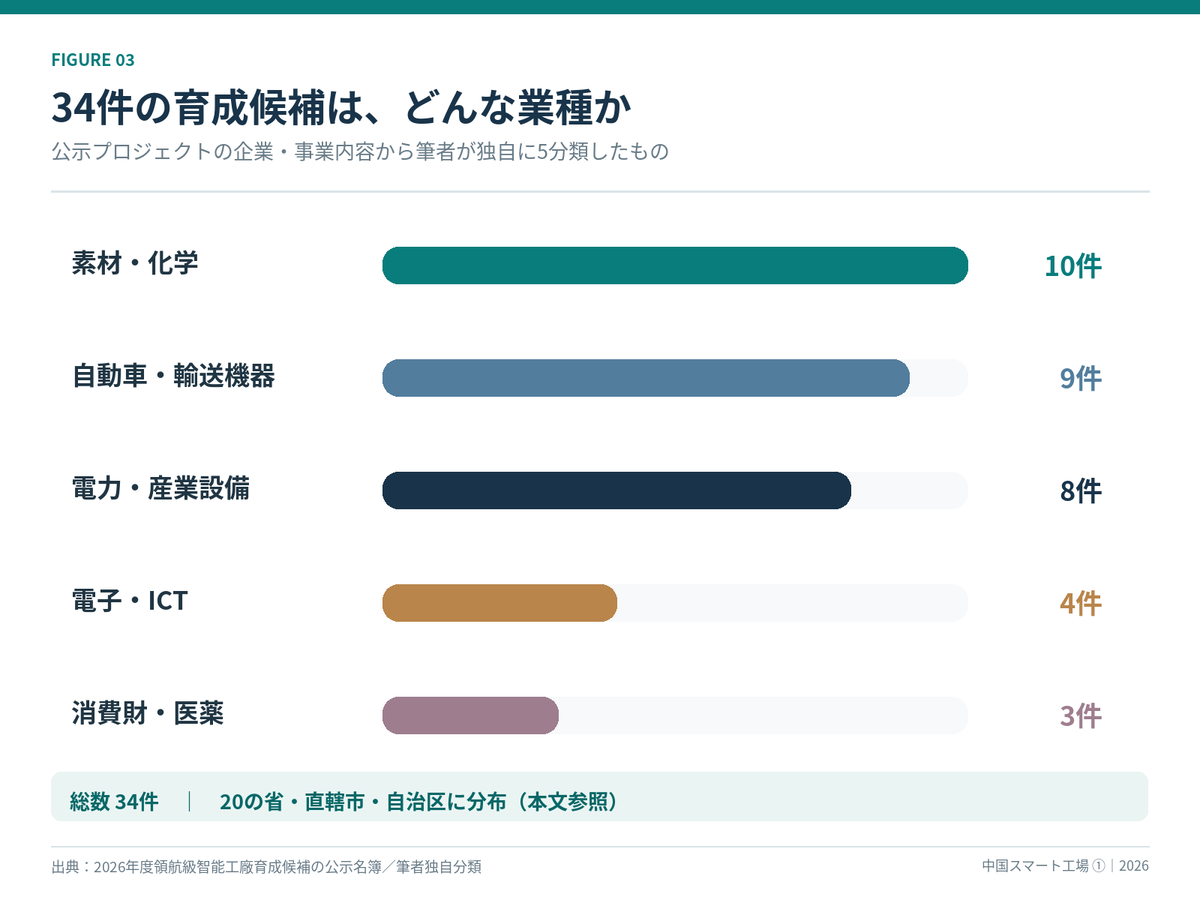
私は公示された企業とプロジェクト名称を読み、編集上の便宜として5つの業種に分類しました。素材・化学10件、自動車・輸送機器9件、電力・産業設備8件、電子・ICT4件、消費財・医薬3件です。これは中国政府の公式業種分類ではなく、今回の読み解きのための独自分類です。

地域別では、江蘇省が6件、山東省と重慶市がそれぞれ3件。合計20の省・直轄市・自治区に広がります。とはいえ、候補件数が多い地域をそのまま「スマート工場の水準が高い地域」と評価することはできません。企業規模、産業構成、申請条件や推薦の仕組みにも左右されるからです。

私が興味深いと思うのは、企業ごとに「何を変革しようとしているか」が異なる点です。

小米汽車は、AIを使った俊敏な新エネルギー車製造を掲げています。一汽フォルクスワーゲンは、多車種の混流生産を「母工場」という考え方と結び付けています。ZTE南京は、複数のAIエージェントを用いて情報とモノの二つの流れを自律化する構想を示しています。

造船分野では、南通中遠海運川崎が「無余量造船」を掲げています。部品や船体ブロックの加工・組立精度を高め、後工程の手直しを抑えるという問題意識につながります。瀘州老窖は、伝統醸造の技能継承とAIを組み合わせる方向です。海瀾之家は、需要把握と短納期対応を組み合わせた柔軟な衣料品生産を掲げています。

これらはあくまで公示プロジェクト名から読み取れる方向性です。すでに実装された技術の範囲や、実測された改善効果まで公示名だけで分かるわけではありません。企業の個別発表や公的資料と突き合わせた分析は、第2回以降で進めます。

大規模な完成車工場では生産ラインの柔軟性が重要でも、伝統食品工場では技能の再現性や品質の安定が中心課題になるかもしれません。最先端の姿は一つではありません。業種が違えば、技術を導入する理由も、評価する成果も変わります。

中国が育てたいのは、優秀な工場だけではない

領航級の育成要件には「母工場」という考え方が登場します。[3]

この言葉は、単に親会社の本社工場を指すものではありません。先進的な技術、主要工程、重要設備を開発・成熟させ、そこで蓄積した製造能力を、他の工場や企業へ展開していく拠点という意味で捉えると理解しやすいと思います。ここでの「母工場」は、今回の育成要件から読み取れる役割であり、個々の候補がどこまで実現したかは別途検証が必要です。

しかし、ある工場で成果が出たからといって、別の工場で同じ成果が出るとは限りません。

設備メーカーが違う。部材の仕様が違う。作業者の技能、品質要求、保守体制も異なる。元の工場で熟練者が暗黙のうちに調整していた部分が、移管先では再現できないこともあります。

生産方式の横展開で移す必要があるのは、機械の配置図やシステムの画面だけではないはずです。標準作業と例外処理、製造条件、判断の根拠、異常時の対応、改善の測定方法、そしてそれを運用できる人材まで含まれます。 もう一つ、横展開するときに考えたいことがあります。元の工場で長年続いてきた判断が、必ずしも今も合理的とは限らないという点です。例えば、生産順序の優先ルールが、顧客の重要度や収益性ではなく、過去の部門間の力関係や一時的な事情で決まっていた可能性もあります。それを「熟練者の知恵」としてそのまま標準化し、AIの判断へ組み込めば、古い妥協まで効率よく広げてしまうかもしれません。これは仮想的なリスクであり、候補企業にその問題があると述べるものではありません。 したがって、技術や業務ルールを移す前に、なぜその方法を採ったのか、現在の条件でも妥当なのか、移管先では何を変える必要があるのかを確認する仕事が欠かせません。標準化は、過去を無条件に正しいものとして固定することではないはずです。

11月7日の記事では、設備を更新しても会社に残せる設計資産という問題を考えました。今回の育成制度は、そこからさらに一歩進み、残した技術や知識を他の拠点や企業へ移せる能力を問うものとして読むことができます。ただし、国家標準GB/T 47859-2026と今回の領航級育成制度は別の制度です。領航級候補の各社が同規格への適合を審査されたと解釈することはできません。

第5回では、この「再現できる能力」を、34件を横断して改めて考えたいと思います。

日系製造業は、何を自社の評価指標にすべきか

ここまで見ると、中国の制度を日本企業も採用すべきだ、という話に聞こえるかもしれません。しかし、私はそう考えていません。

AI適用場面比率を60%へ引き上げることが、自社工場にとって合理的とは限らないからです。成熟した既存設備を長く使う工場もあれば、製品の変更が頻繁で、柔軟性に投資する価値が高い工場もあります。設備投資が小さくても、品質が安定し、納期を守り、利益を確保している工場は十分に強いと言えます。

参考になるのは、数字をそのまま輸入することではなく、技術導入と業務成果をつなげて評価する姿勢です。

例えば、AIによる需要予測を導入するなら、予測精度だけでなく、欠品率、在庫回転、緊急輸送費まで見ているでしょうか。MESを入れるなら、進捗が見えるようになっただけでなく、納期遅延の兆候を早く発見し、実際の対応につながっているでしょうか。品質検査を自動化するなら、検査工数だけでなく、工程内不良や再加工の減少まで確認できているでしょうか。 こうした評価には、現場のデータ定義をそろえる作業も伴います。受注納期遵守率なら、「顧客との約束日」をいつ確定し、変更した場合はどの履歴を使い、出荷と着荷のどちらを達成とみなすのか。指標の名前だけ統一しても、工場や販売拠点によって計算方法が違えば、数字を並べても意思決定につながりません。

私は、技術投資を検討する際には、少なくとも次の問いを持ちたいと思います。

  1. 何を改善するための投資なのか。 課題を設備・システムの名称ではなく業務で説明できるか。
  2. 成果を何で測るのか。 品質、在庫、納期、コストなど、導入前後で追える指標があるか。
  3. 改善が別の負担を生んでいないか。 調達、物流、営業、保守などへ問題を押し出していないか。
  4. 担当者や設備が変わっても続けられるか。 工程条件、判断方法、例外対応が会社に残るか。
  5. 成功した方法を、どこまで横展開できるか。 他拠点での再現条件と、展開しない方がよい条件を説明できるか。

これらは中国の育成要件にそのまま書かれた五つの質問ではありません。制度と22項目の参考KPIを踏まえ、私が日系企業の経営・生産管理の実務向けに整理したものです。

また、中国の先進事例を検討するとき、導入企業の公表数字をそのまま自社の効果予測に使うことも避けたいと思います。生産量、製品構成、改善前の水準、計測期間、投資額、外部サービスへの依存度が異なれば、同じ「生産性30%向上」という表現でも意味が変わるからです。成功事例を知ることは有益ですが、再現するための条件を調べることにこそ価値があります。

まとめ――最先端とは、技術を多く持つことだけではない

今回の34件の育成候補と2026年版の参考KPIから読み取れるのは、中国がスマート工場を、設備の自動化やAI導入だけで評価しようとしているのではないということです。

技術を導入する。生産・経営の成果につなげる。環境負荷や資源の使い方も改善する。そして、その能力を他の工場やサプライチェーンへ広げる。私は、この流れに領航級育成制度の特徴があると考えます。 ただし、測る指標を増やせば自動的に良い工場になるわけではありません。数字の裏側にある業務の条件をそろえ、なぜその判断をしたのかを残し、古いルールは見直す。その地道な運営能力が伴って初めて、技術も横展開も意味を持つのだと思います。

もっとも、制度が目指す姿と、候補企業が既に実現している姿は分けなければなりません。次回以降は、企業が公表している技術と成果を個別に確かめ、どこまでが実績で、どこからが構想なのかを見ていきます。

最先端の工場を判断するとき、見るべきなのは、導入した技術の数だけではなく、その技術によって何を改善し、どの能力を組織に残せたかだと思います。

次回は、小米汽車と一汽フォルクスワーゲンを中心に、自動車製造の生産方式をどう変えようとしているのかを取り上げます。

今回はここまでとします。最後までお読みいただき、ありがとうございました。

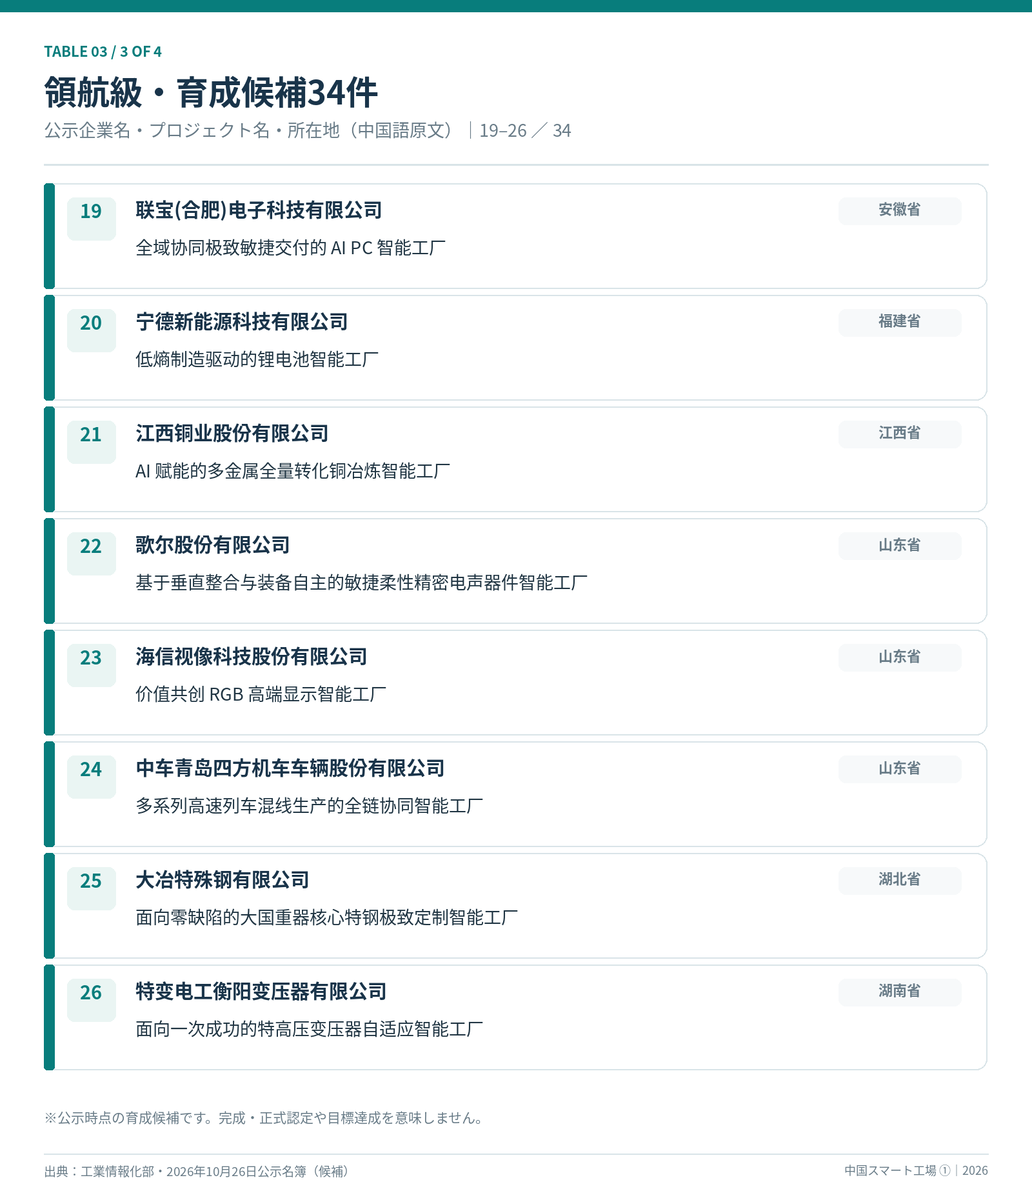
付表|2026年度領航級スマート工場・育成候補34件

以下は工業情報化部が公示した企業とプロジェクト名・所在地です。名称は原文を優先して収録しました。公示段階の育成候補であり、記載された技術や効果がすべて達成済みという意味ではありません。[1] なお、業種分類、論点整理、仮想例、日系企業への提言は筆者による分析であり、個別工場の能力達成や第三者による成果検証を示すものではありません。

参考資料

[1] 中国工業情報化部「关于2026年度领航级智能工厂项目培育名单的公示」(2026年10月26日)。公示期間:10月27日〜11月2日。企業・プロジェクト名称および所在地は公示名簿に基づきます。
https://www.miit.gov.cn/jgsj/zbys/znzz/art/2026/art_9b66cbd1acce49118fef59e698f40112.html [2] 中国工業情報化部等6部門「关于开展2026年度智能工厂梯度培育行动的通知」(2026年7月15日付、7月17日公表)。
https://www.miit.gov.cn/zwgk/zcwj/wjfb/tz/art/2026/art_bbccc17a650749c2a76569679350fa5d.html [3] 同通知・附件1「智能工厂梯度培育要素条件(2026年版)」、とくに基本要件、卓越級・領航級の建設成果、附表「智能工厂建设关键绩效指标参考」。
https://www.miit.gov.cn/cms_files/filemanager/1226211233/attach/20267/670be81cbc174002bee25f338c253559.pdf [4] C. A. E. Goodhart, “The ECB and the Conduct of Monetary Policy: Goodhart’s Law and Lessons from the Euro Area,” Journal of Common Market Studies, 44(4), 757–778 (2006). グッドハートの法則の趣旨を参照。 https://doi.org/10.1111/j.1468-5965.2006.00661.x

〖週末特別コラム〗AIは、企業が蓄積した専門知識をどう使うのか ―― 中国・北森の人事AIと企業導入事例から考える

皆さん、こんにちは。

技術者として優秀だった人が、管理職になる。製造業では珍しくありません。ただ、自分で問題を解決する能力と、部下が問題を解決できるようにする能力は同じではありません。

部下との面談で何を伝え、何を聞くか。相手が納得しなかったらどうするか。新任管理職がこうした場面を練習する機会は、十分にあるでしょうか。

中国の造船会社・揚子江船業では、AIを管理職の練習相手として利用しています。私がこの事例で興味を持ったのは、AIが人の代わりに管理職になることではなく、これまで経験を通じて学んできたことの一部を、繰り返し練習できるようにした点です。

ただし、AIは何を基準に「適切な対応」を評価するのでしょうか。

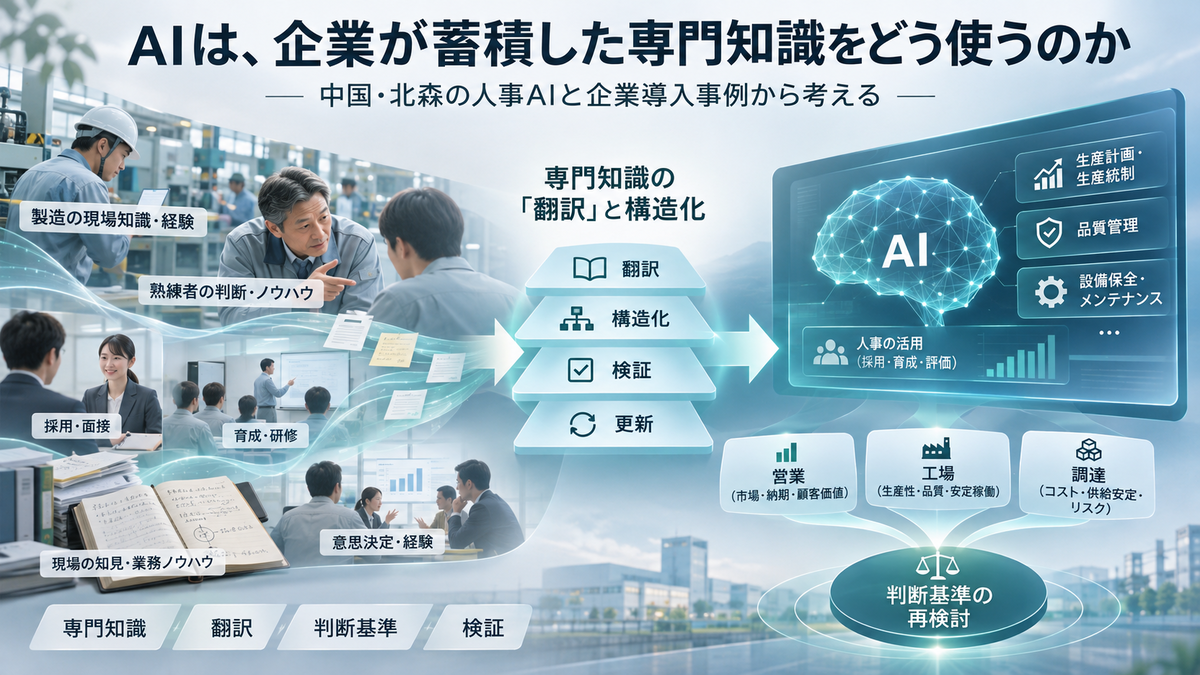
2026年9月、Harvard Business School(HBS)は中国の人事テクノロジー企業・北森(Beisen)のAI事業転換をケースとして取り上げました。北森は20年以上蓄積してきた人材評価や心理測定の専門知識を、AIによる面接や管理職育成などへ展開しています。

今回は北森の具体的な取り組みを見ながら、企業が持つ専門知識をAIへ使わせることの可能性と、その難しさを考えてみたいと思います。

造船会社がAIを管理職の練習相手にした

揚子江船業は、江蘇省の複数の造船拠点で大型船舶を建造する企業グループです。大型船の建造では、設計や生産技術だけでなく、資材、工程、安全、品質、協力会社との連携が複雑に重なります。そこで求められる管理職の能力は、自分の担当工程に詳しいことだけでは足りません。

北森が公開した事例では、同社が直面していた課題として、専門技術の担い手から管理職への転換が挙げられています。自ら仕事を完遂する人から、他の人を通じて仕事を進め、部下を育てる人への転換です。これは製造業で広く見られる課題でしょう。

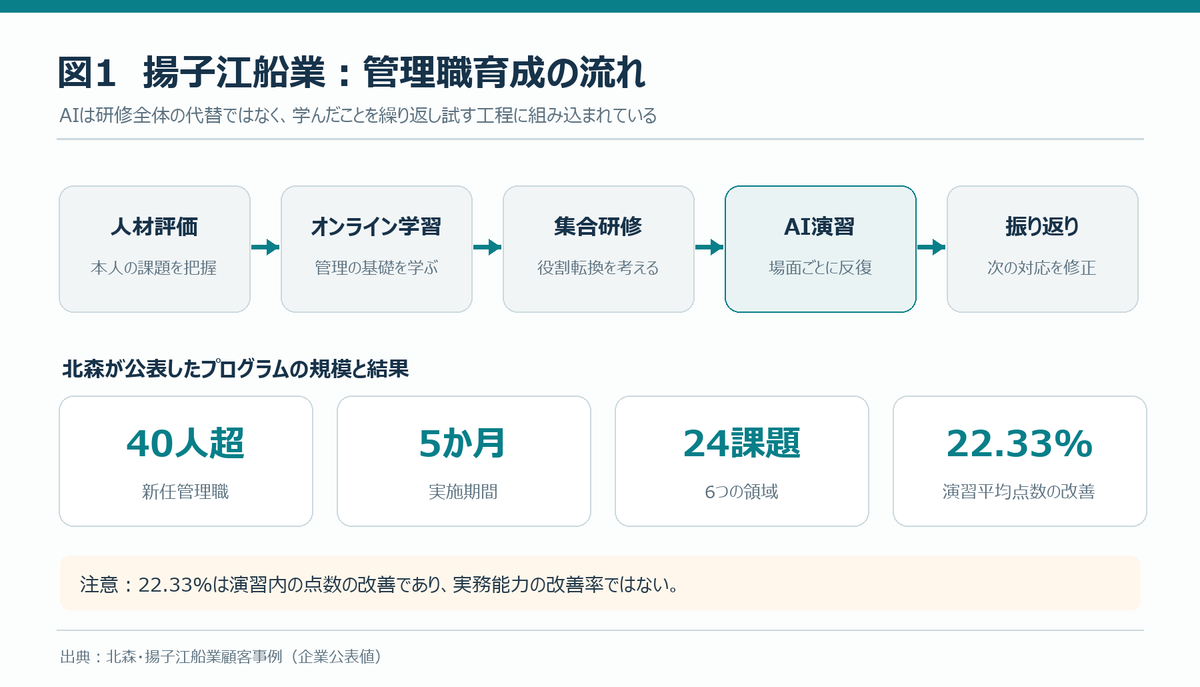
同社は新任管理職向けに「新聘干部动力营」という育成プログラムを設けました。ここで重要なのは、AIをいきなり研修の代替として使ったわけではないことです。まず人材評価をもとに本人の課題を把握し、オンライン講座で基礎を学び、集合研修では評価レポートの読み解き、管理者としての役割転換、チーム活動などを扱いました。その後にAIリーダーシップコーチ「Mr. Sen」による演習を組み込んでいます。

この順番には意味があります。知識を教えるだけの研修では、「理解したつもり」と「実際に対応できる」の間に距離が残ります。そこでAIを使って、学んだ内容を具体的な場面で試す機会を設けています。北森の資料では、6つのリーダーシップ領域にわたる24の管理課題が取り上げられています。

例えば、他部門との資源調整が進まない場合です。部門間の利害が食い違う中で、相手の状況をどう確認し、協力をどう引き出すのか。現実のプロジェクトなら、一度の言い方や判断が納期にも関係します。研修の場では、同じ状況に異なる応答を試し、振り返ることができます。北森は、演習で得た気づきを部門間調整の実務へ使った例も紹介していますが、その効果を独立に測定した研究結果として提示しているわけではありません。

40人を超える新任管理職が5か月にわたり参加し、AI演習の平均点数は22.33%改善したと公表されています。これは、管理職としての実際の成果が22.33%上がったという意味ではありません。複数の教育手段を組み合わせたプログラムですから、AIだけの寄与率も分かりません。

それでも、この事例には二つの発見があります。一つは、実務に近い対話を反復できるようにしたこと。もう一つは、組織が「望ましい管理行動」を定義しなければ、その演習を評価できないことです。現場の優秀な技術者が管理職になった際、どの行動を新たに学ぶべきなのか。それを会社側が説明できているかどうかが、AI活用の前提になっています。

出典:北森・揚子江船業事例。

人材評価からAIへ――北森が蓄積してきたもの

北森は2002年に設立され、人材評価・心理測定から人事管理SaaSへ事業を広げてきました。特徴は人事システムを提供していることだけでなく、人材評価の考え方や能力モデルを長年蓄積してきたことです。

2026年6月、北森はAIアプリケーション企業への転換と、AI HR専門家プラットフォーム「Mavens」を発表しました。同年9月には、HBSがこの事業転換を教材ケースとして取り上げています。HBS公開概要では、AIによる候補者面接が累計200万件を超えたと紹介されています。

ただし、HBSに取り上げられたことは、北森のAIの精度や有効性が第三者によって実証されたことと同じではありません。ケースは、企業の転換とAI導入の難しさを考える教材です。

例えばAIへ「優秀な管理職を選んで」と依頼したとします。売上が高い人なのか、部下を育てられる人なのか、変化への対応が得意な人なのか。企業が何を重要視するかによって、評価は変わります。

高性能なモデルを導入しただけでは、その会社の「優秀」の意味まで決まるわけではありません。

専門知識をAIに使わせるまでの「翻訳」

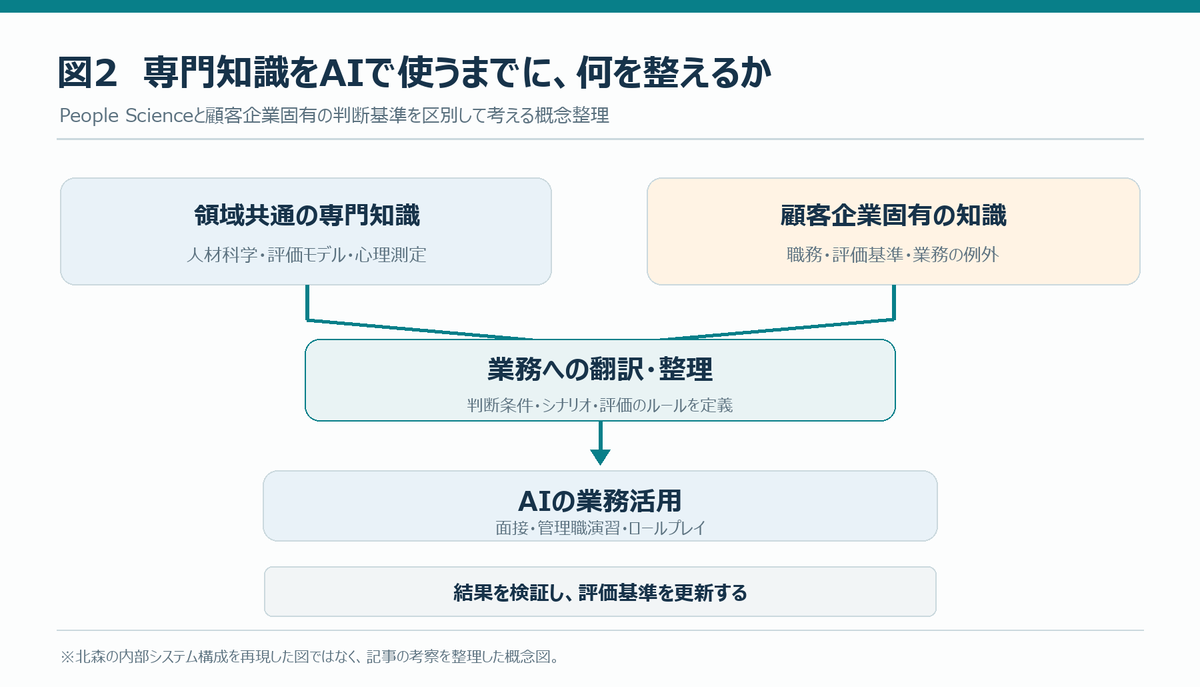
北森は人材評価や心理測定、能力モデルなどの専門知識を「People Science」と呼んでいます。2026年に新しく生まれた理論ではなく、同社が蓄積してきた領域知識です。

北森の説明では、MavensはこのPeople Scienceを、領域特化モデル「SenGPT」やAgent体系「SenClaw」などと組み合わせます。ただし、専門知識をAIへ組み込むことは、必ずしも基盤モデルそのものを追加学習することではありません。知識の参照、評価基準、業務ルール、対話シナリオなど、方法はいくつもあります。公開されていない内部技術を断定しないようにしたいところです。

もう一つ区別すべきなのは、北森が持つ一般的な人材科学の知識と、顧客企業固有の判断基準です。

例えば同じ管理職でも、造船会社と小売業では求める行動が異なるでしょう。同じ製造業でも、量産と個別受注では判断が違います。顧客企業の業務を理解しなければ、一般的な専門知識をそのまま使うことは難しいはずです。

北森は2026年6月の発表で、300人超のFDE(Forward Deployed Engineer)チームを公表しました。ここから各案件の工数や費用を推定することはできませんが、顧客ごとの業務や評価基準を実装へつなぐ仕事を重要視していることは読み取れます。ここで求められるのは単なるプログラムの開発だけではなく、現場にある曖昧な経験則を聞き取り、判断の条件や例外を整理して、AIが扱える形へ翻訳する仕事でもあります。ただし、北森のFDE全員がこの作業を担当していると確認できたわけではありません。

例えばベテラン社員に「なぜこの取引先を優先するのですか」と聞くと、「これまでの経験です」という答えが返ってくるかもしれません。しかし、その背後には利益率、欠品の影響、過去の約束、顧客との関係など複数の事情があるはずです。

それを他の担当者やAIにも使える形にするには、単にマニュアルを読み込ませる以上の作業が必要になります。さらに、担当者同士で判断が食い違った場合、何を組織の基準とするかを決めなくてはなりません。

AIを導入することと、AIに使わせる知識を整えることは別の仕事なのです。

長安汽車と利欧集団――AI面接の前に決めたこと

北森のAI面接を採用した長安汽車と利欧集団は、ともに製造業に関係する企業ですが、課題は同じではありません。前者は大規模グループでの基準統一と海外展開、後者は大量応募への対応と将来の人材像の明確化が中心です。この違いを見ると、AI面接の導入とは単に面接官を置き換えることではないと分かります。

長安汽車――AI面接を導入する前に確かめたこと

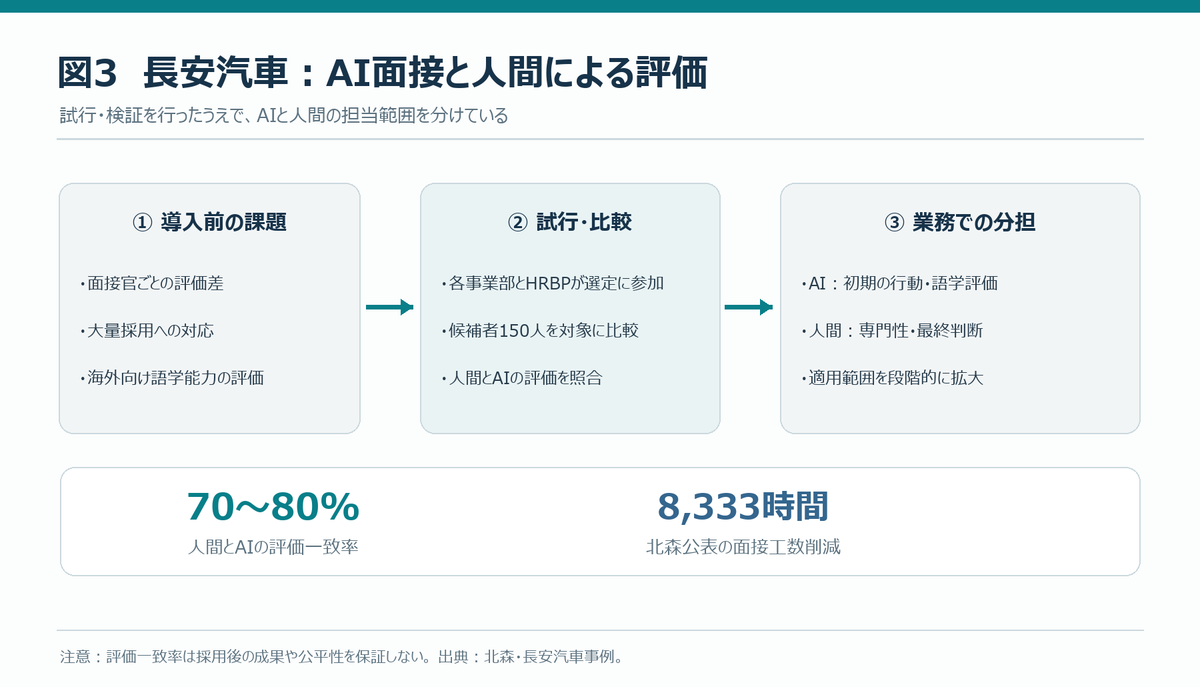
長安汽車は電動化・知能化・海外展開を進めており、北森の事例では2026年卒の新卒採用規模が前年より30%増えたと説明されています。大量採用だけでなく、部門や子会社によって面接官の経験が異なり、評価基準がそろいにくいこと、海外事業で必要な英語能力の評価に負担がかかることも課題でした。

導入で印象的なのは、ツールの選定を人事部門だけで決めなかった点です。北森の説明では、各事業部とHRBPが製品を試し、評価に参加しました。使う現場が選定に関わり、対話の自然さや追質問の仕方が、自社の採用方法と合うかを見ています。本社の方針だから導入するのではなく、実際に採用を担当する側が納得できる仕組みにしようとしたわけです。

次に、150人の候補者のAI面接を抽出し、人間が録画や回答記録を共通基準で評価して、AIの評価と比較しました。公表された一致率は70〜80%です。ここでの比較は、AIの出した判断を何らかの方法で検証しようとした点で意味があります。しかし、評価者が同じ回答を見ていることや、評価項目の構成によっても一致率は変わり得ます。この数字だけで、候補者の将来の活躍を予測できたとは言えません。

試行後、同社は新卒採用の全職種と中途採用の一部へ用途を広げ、AIが行動能力や語学面などの初期評価を担当し、専門性や最終的な適合性は人が確認する設計にしています。北森は二次面接通過率20%改善、面接工数8,333時間削減、秋季採用のAI面接回答完了率85%を報告しています。なお通過率の「20%改善」が相対変化なのか百分率ポイントなのかは、原文の表現のみでは厳密に断定しません。

面接時間が短くなることは分かりやすい成果です。しかし、私が注目したいのは、選定時に業務部門を巻き込み、試行評価を経て、人とAIの役割分担を決めた順番です。AIを入れたことで統一基準ができたのではなく、何を共通基準にするのかを先に議論したからこそ、AIを使う範囲が決められたと見る方が実務的でしょう。

出典:北森・長安汽車事例。

利欧集団――最大10万件の応募と、5年先の人材像

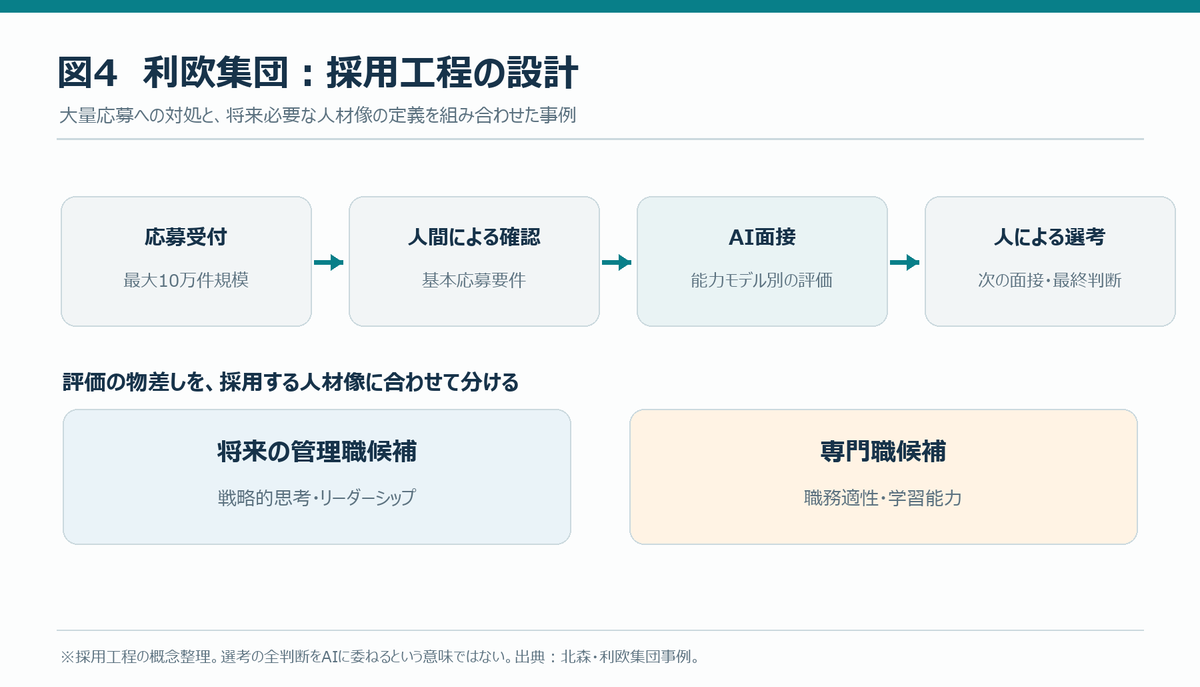
利欧集団の課題は、まず応募者の量にありました。北森によると、2023年にグループ全体の新卒採用を統括するようになり、秋季には応募書類が最大10万件規模に達しました。従来の一次選考には2〜3か月を要し、候補者への回答が遅れることで、優秀な人材が他社へ流れる懸念もあったといいます。

ただし、同社は応募者全員をいきなりAIに評価させたわけではありません。最初に人事担当者が基本的な応募要件を確認し、対象者を採用管理システムからAI面接へ引き継ぐ形を採っています。AIを組み込む前後の工程を含めて設計したことが特徴です。

さらに、採用対象を一つの物差しでは評価していません。将来の管理職候補と専門職候補について、今後5年間の事業戦略を踏まえ、異なる能力モデルを作ったと説明しています。管理職候補では戦略的思考やリーダーシップの可能性、専門職候補では職務適性や学習能力を重視するという設計です。面接では応募動機・定着可能性、コミュニケーション能力、行動能力などの観点を組み合わせ、過去の行動を掘り下げる質問も使っています。

つまり、利欧集団がAIへ移したのは、一般論としての「優秀な人材」の判定ではありません。自社が今後どのような事業を進め、そのためにどのような人を採用したいかという経営側の選択です。AIが何を尋ねるかは、その人材像に依存します。

北森は、書類選考の日次処理が進み、新卒採用の期間が短縮したほか、二次面接通過の割合が従来の「10人に1人」から「10人に5人」になったと報告しています。これは候補者を絞る方法が変わったことを示唆します。ただし、選考母集団や基準が変わっている場合、単純な前後比較だけで採用の質が5倍になったとは言えません。入社後の成績や定着率は別の追跡が必要です。

ここで読者が自社に引きつけて考えられるのは、応募者数より前の問題です。そもそも採用する部門と人事部門が、必要な能力を同じ言葉で説明できるでしょうか。AI面接を導入する作業は、人材像を曖昧なままにできなくする作業でもあります。

出典:北森・利欧集団事例。

信達生物――知識を覚えるだけでなく、使う練習へ

2026年10月29日の北森ユーザー大会で紹介された信達生物の事例は、採用とは異なる問題に取り組んでいます。対象は医薬品営業の継続的な訓練です。製品の知識を覚えることと、顧客との実際の会話で適切に使えることは同じではありません。

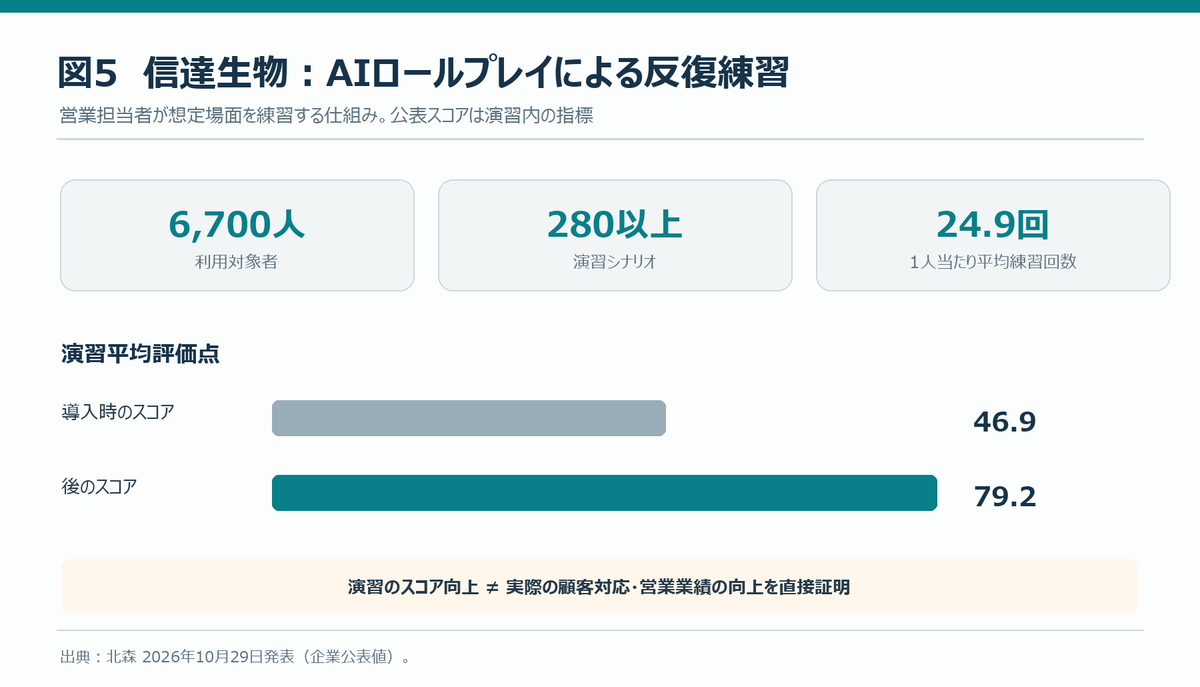
北森の発表では、6,700人の医薬品営業担当者を対象に、280以上の演習シナリオを提供しています。シナリオには、診療科での会合における説明や訪問時の対話などが含まれます。一人当たり平均24.9回練習し、平均評価点は46.9から79.2へ上昇したと公表しています。

ここで重要なのは、単にAIが質問に答える仕組みを提供しているのではなく、相手から質問される場面を作り、何度も応答を試せるようにしていることです。講義で知識を学んだ後、実務に出る前に適用を練習する。揚子江船業の管理職研修と似ているようで、求める技能は異なります。営業では製品説明の正確性や質問への応答、管理職では相手を動かすためのコミュニケーションや判断が中心になるからです。

280以上というシナリオ数にも注目できます。ただ数が多ければよいのではなく、職種、顧客の状況、想定される質問、誤った説明を避ける条件を誰が選び、更新するのかが重要になります。医薬品の説明には正確性や規制上の制約もあるため、AIがもっともらしく誤った説明をした場合の扱いを設計しなければなりません。ただし、北森の公開発表では各シナリオの監修方法や評価基準の詳細までは確認できません。

平均点46.9から79.2への改善は大きな変化ですが、演習内の尺度です。練習を重ねると評価の高い言い回しを習得することもあります。反対に、本当に顧客対応が上達していることも考えられます。両者を区別するには、実地の対応品質、適切な説明の遵守、営業成績などを別に確認する必要があります。さらに比較条件が公表されていないため、AI演習が改善の唯一の原因だったとも言えません。

製造業に置き換えるなら、品質クレームの初動対応や納期遅延の顧客説明などが考えられます。どこまで事実が確認できているのか。何を約束し、何は保留すべきか。そうした説明を実際の顧客相手に試す前に練習できる価値はありそうです。しかし、その際も評価基準の正確さを確かめることが先にあります。

北森の同じ発表には、正大天晴で22の管理場面を演習化し、参加者が平均119.8分練習した事例もあります。これらに共通するのは、AIが知識を提供するだけでなく、仕事の場面を再現して練習の回数を増やす方向へ使われていることです。

出典:北森・2026年10月29日発表。

数値で報告された成果は、何を証明するのか

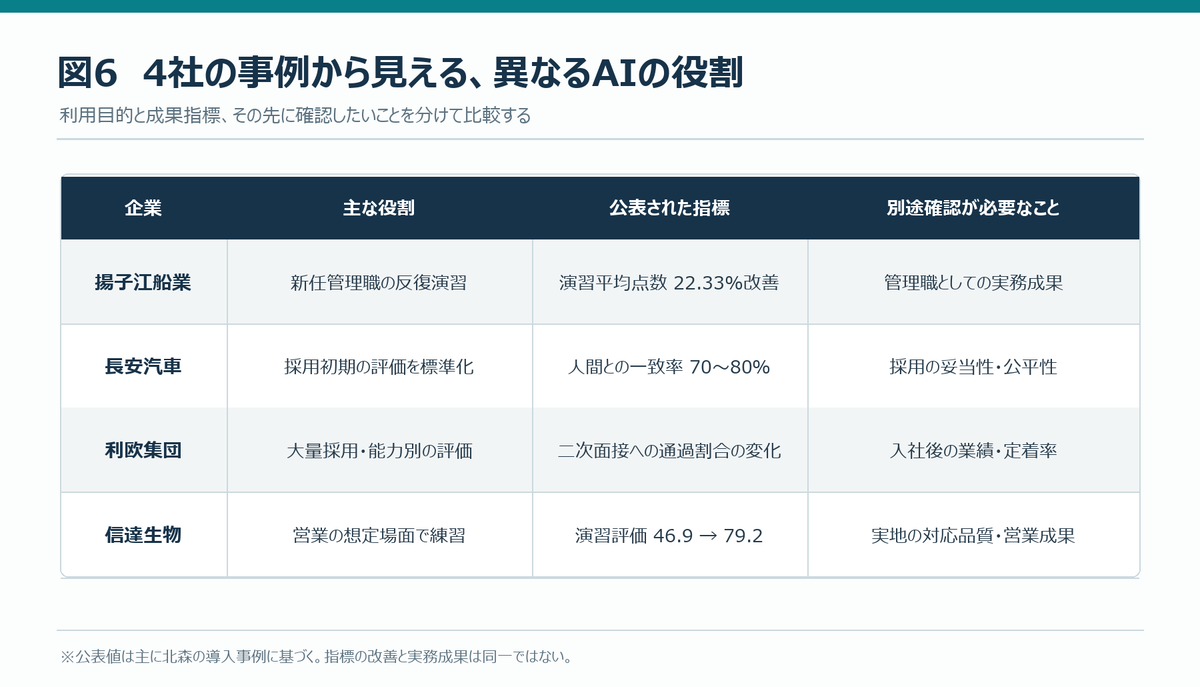
4社の導入目的と、成果を評価する際に分けて考えたい点を並べると、次のようになります。

ここまでに、22.33%の改善、70〜80%の一致率、46.9から79.2へのスコア改善という数字が登場しました。いずれも北森側の公表値です。

これらの数字は無意味ではありません。利用の広がりや、演習内で変化が起きたことを理解する手がかりになります。

ただ、何を測ったのかを確認する必要があります。

人間とAIの評価が一致しても、人間の評価が正しいとは限りません。AI演習の点数が上がっても、実際の管理能力や営業成績が上がったとは限りません。改善している可能性はありますが、それを裏付けるには別の情報が必要です。

ここで参考になるのが、グッドハートの法則です。測定指標を強く目標化すると、その数値が本来測りたかった成果を十分に表さなくなることがあります。

ここで演習スコアは、現場での営業力を間接的に測るための「代理指標」です。信達生物のように反復回数と演習点数が伸びた事例でも、実際の顧客対応や業績まで同じように改善したかどうかは、別に確認する必要があります。例えば演習の採点基準に合わせた話し方を習得すれば、スコアは上がるかもしれません。それが本当の対話力につながる場合もありますが、想定外の質問には対応できないかもしれません。どちらなのかは、演習の点数だけでは判断できません。

これは製造業にも通じます。設備稼働率を高めようとして不要な製品を作れば、在庫が増えます。在庫金額だけを減らそうとすれば、欠品のリスクが高まる場合があります。

指標は必要です。しかし、指標の改善と、仕事の成果を混同しないことも必要です。

専門知識は、正しい知識とは限らない

企業が長年蓄積した知識には価値があります。ただ、長年使ってきたという事実だけで、今も合理的だとは限りません。

以前は調達期間が長く、欠品を防ぐために多くの在庫を持つことが合理的だったかもしれません。ところが調達先や物流条件が変わった後も同じ発注量を続ければ、過剰在庫になる可能性があります。

ある品質問題を契機に設けた承認手続きが、その後の工程改善によって不要になっていることも考えられます。それでも昔の手続きをAIへ組み込めば、AIはその手続きを効率よく実行するでしょう。

処理は速くなっても、業務が合理的になったとは限りません。

ここで大切なのは、知識を残すことだけではなく、見直すことです。過去に有効だった知識を現在の条件に合わせて更新し、必要なら手放す。こうしたアンラーニングの視点も必要になります。

さらにAIでは、一つの判断基準を多くの業務へ展開できます。正しい基準なら大きな利点ですが、偏りや古い前提が含まれていれば、その問題も広がり得ます。

どの知識を使うかと同じくらい、どの知識を今も使うべきかを判断する仕組みが重要なのだと思います。

製造業の現場には、異なる「正しさ」がある

人事の話から少し離れて、生産管理の場面を考えてみます。

ある工場で部材の納入が遅れ、すべての製品を予定どおり生産できなくなったとします。

営業は大口顧客Aを優先したい。欠品による影響や顧客との約束を重視しています。

工場は段取り替えの少ない製品Bを先に作りたい。限られた時間で生産量を確保したいからです。

購買は部材の入荷状況から、製品Cを優先したいと言うかもしれません。

それぞれに合理的な理由があります。しかし、会社としては優先順位を一つに決めなくてはなりません。

ベテランの生産管理担当者は、過去の事情や部門間の関係も踏まえて調整するでしょう。ただ、その判断理由が残っていないと、別の担当者が同じ状況で判断できるとは限りません。

AIに優先順位を考えさせるなら、売上高、粗利益、欠品ペナルティ、顧客への影響、生産効率、部材の制約など、何をどう評価するかを決める必要があります。

しかも、すべてを数字へ置き換えられるとは限りません。長期的な顧客関係など、数字だけでは説明しきれない事情もあります。

AIの導入を考える過程で、これまで暗黙のうちに調整してきた判断基準が、部門ごとに異なっていたことに気づくかもしれません。

品質管理でも同じです。不具合が起きたときに出荷を止めるのか、在庫を隔離するのか、追加検査を行うのか。過去の報告書に対応結果が残っていても、なぜその時点でその対応を選んだのかまでは残っていない場合があります。

設備保全では、熟練者が異常音や振動から故障の兆候を感じ取ることがあります。ただ、その経験をすべて文章へ変換できるとは限りません。何を形式化し、どこに人間の確認を残すかも考える必要があります。

専門知識のAI活用とは、何でもAIへ任せることではなく、組織として判断の前提を理解できるようにすることでもあるのでしょう。

AI導入より前に、企業は何を整えるべきか

では、最初からすべての業務の判断基準を整理する必要があるのでしょうか。

私は、そうは思いません。

繰り返し発生し、判断の結果を検証でき、間違いが起きた場合の影響を管理しやすい業務から始める方が現実的でしょう。

例えば管理職の演習であれば、AIの助言は練習用として扱い、実際の人事評価から切り離せます。一方、出荷停止や採用の最終判断など、結果の影響が大きい業務では、人間が確認し、責任を持つ設計が必要です。

次に、判断の結果だけでなく、その理由を残します。生産計画を変更したなら、何を優先したのか。どの前提が変わったのか。他に選択肢はなかったのか。結果として何が起きたのか。

こうした情報があれば、将来の判断を見直す材料になります。

さらに、判断基準の更新を誰が担うのかも重要です。顧客や製品、調達条件、法規制が変われば、基準も変わります。AIに使わせる知識を、導入時点のまま固定してよいわけではありません。

最後に、AIの成果は処理時間や演習点数だけで判断しないことです。納期回答が速くなっても納期が守られなければ十分ではありません。品質報告が早く作れるようになっても、不良の再発が減らないなら、別の問題が残っているかもしれません。

AIの判断が人間と違ったときも、AIだけを疑うのではなく、従来の判断基準を見直す機会にできるはずです。

まとめ

北森の取り組みを調べながら、私が考えたのは、AIモデルの性能だけではありません。

どの会社にも、長年の仕事を通じて蓄積された知識があります。熟練者の判断、顧客との約束、過去の失敗から生まれたルール。

ただ、それが必ずしも組織の知識になっているとは限りません。

担当者が休むと判断できない。担当者が替わると対応が変わる。過去の経緯を知る人がいなくなると、なぜそのルールがあるのか分からなくなる。

AIに判断基準を教えようとすると、これまで説明しなくても仕事が進んでいた理由を、改めて説明しなければならなくなります。

なぜこの顧客を優先するのか。なぜこの人材を高く評価するのか。なぜこの手順を守るのか。

その理由が明確になることもあれば、実は誰も十分に説明できないことに気づくかもしれません。

さらに、説明できたとしても、それが今も正しい判断とは限りません。

AIを導入するために始めた作業が、結果として自分たちの仕事を見直す機会になる。

AIに何を教えるかを考えることは、自分たちが何を知っていて、何を正しいと考えているのかを問い直すことでもある。

参考資料

以下は公開資料を参照したものです。HBSの有料ケース全文は確認していません。導入効果の数値は主として北森公表値であり、独立した第三者検証を意味しません。

  1. Harvard Business School, Beisen: Crossing the Chasm with AI in Human Capital Management(公開概要、2026年9月14日)
    https://store.hbr.org/product/beisen-crossing-the-chasm-with-ai-in-human-capital-management/427036
  2. 北森「Mavens」公式発表(2026年6月24日)
    https://www.beisen.com/news/670.html
  3. 北森・揚子江船業導入事例
    https://www.beisen.com/customer/269.html
  4. 北森・長安汽車導入事例
    https://www.beisen.com/customer/277.html
  5. 北森・利欧集団導入事例
    https://www.beisen.com/customer/267.html
  6. 北森・2026年10月29日のユーザー大会発表
    https://www.beisen.com/news/711.html
  7. 北森・テンセントクラウド協業発表(2026年10月30日)
    https://www.beisen.com/news/712.html

〖週末特別コラム〗中国スマート工場国家標準と日系製造業の経営判断

設備をつなぐだけでなく、生産の仕組みを組み替えられる工場へ

皆さん、こんにちは。

「中国のスマート工場」と聞くと、ロボットが整然と並ぶ無人化ラインを思い浮かべる方もいるかもしれません。自動化された設備や、その稼働率が注目されるのは自然なことです。しかし、2026年に公布された中国の新しい国家標準を読むと、主役はロボットの性能でも、無人化率でもありませんでした。そこに書かれていたのは、設備と動作をどう記述し、生産システムをどう組み替えられるようにするか、という設計のルールです。

中国に工場を持つ日本企業で、設備の更新や生産ラインの変更を検討するとき、こんな場面はないでしょうか。新しい装置を入れれば能力は上がるはずなのに、既存設備との接続や制御プログラムの調整に想定以上の時間がかかる。複数メーカーの装置が混在し、工程を少し変えるだけでも、元の導入会社に作業を依頼しなければならない。設備は自社の資産でも、その設備を動かす「仕組み」は自社の手元にどこまで残っているのか。私は、この点に強い関心を持っています。

2026年7月2日、中国で国家標準GB/T 47859-2026「智能工厂 生产系统可重构建模规则」が公布されました。日本語では「スマート工場―生産システムの再構成可能なモデリング規則」と訳せます。実施予定日は2027年2月1日です。[1] 10月16日のLinkedInでは制定を速報として紹介しましたが、今回は規格本文の第1〜8章と附属書A〜Cを読み、経営上の意味を掘り下げます。

規格の焦点は、工場の設備、ソフトウェア、それらが行う動作、工程の実行順序を共通のモデルで記述し、状況に応じて組み合わせ直すためのルールにあります。経営層にとって重要なのは技術用語そのものではありません。設備を更新するとき、何をつくり直し、何を再利用できるか。そして、更新の自由度を自社にどれだけ残せるかという問題です。

本記事では、原文に書かれた技術的な事項と、私が日系企業の経営判断に結び付けた考察を分けて説明します。読者として想定しているのは、日本本社の経営層・技術担当役員、中国現地法人の董事長・総経理・工場長です。技術的な条項を自ら確認したい方のために、規格の章・条項・表・図・附属書と照合できる非公式の「日本語参考訳(PDF)」も併せて公開します。

日本語参考訳PDF(66ページ/非公式・原文対照版) 規格の第1〜8章・附属書A〜Cの内容と、表の日本語・中国語対照、原図および主な図中文字の用語対照を収録しています。

PDFのリンク: 日本語参考訳PDFを閲覧・ダウンロード(Google Drive)

※非公式の参考訳です。条項の解釈、適合評価、契約上の判断では、最新の中国語正式原文を優先してください。

推奨性国家標準だから、対応しなくてよいのか

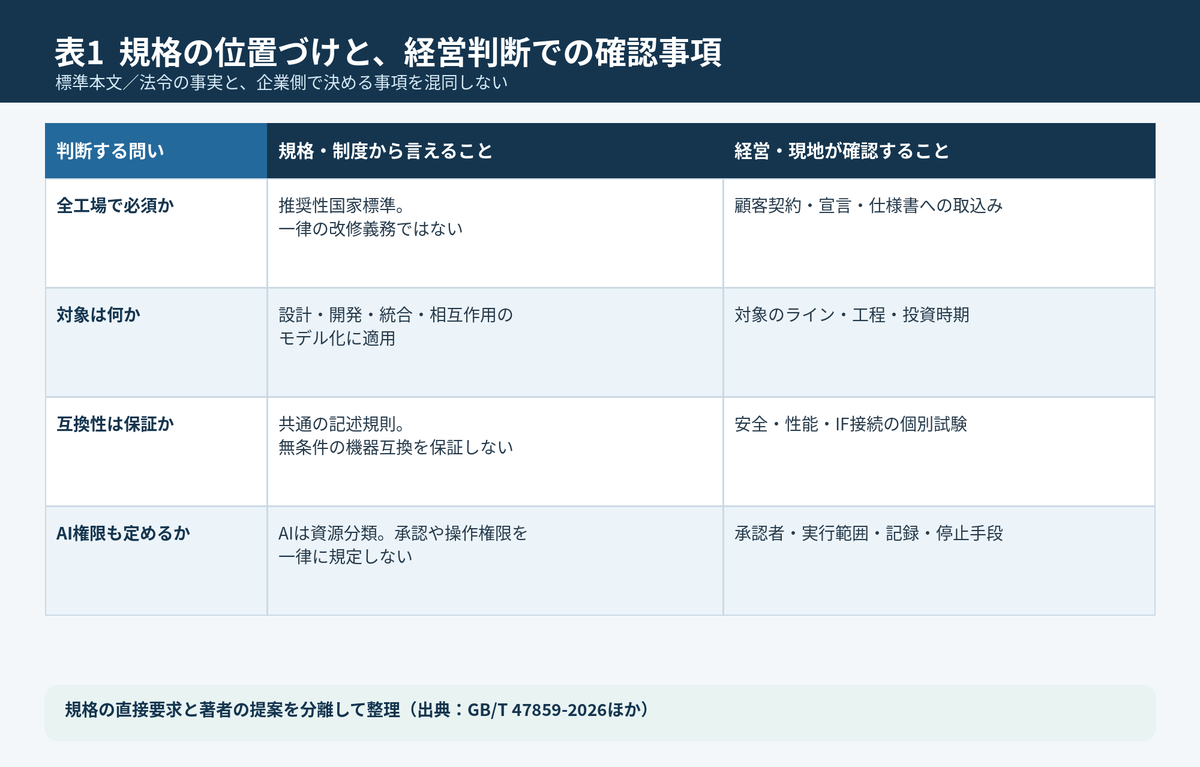
まず、この標準の法的位置づけを正確に理解する必要があります。GB/T 47859-2026は「推奨性国家標準」です。中国の標準化法第2条は、強制性標準は実施しなければならず、推奨性標準は国が採用を奨励するものと区別しています。[2]したがって、新標準ができたことだけを理由に、中国国内のすべての日系工場が2027年2月までに設備やMESを改修しなければならない、という説明は正確ではありません。

一方、「推奨性だから関係ない」と結論づけることも早計です。特定の取引契約で標準への適合が求められる場合、企業がその標準を実施基準として対外的に示している場合、顧客の設備仕様や新規案件の条件に組み込まれる場合には、具体的な確認が必要です。契約上の効力や表示内容は、それぞれの事実関係で判断すべきであり、この規格が一律の義務を新設したと理解する必要はありません。

対象範囲にも注意が必要です。規格の「適用範囲」では、スマート工場の生産システムの設計、開発、システム統合、相互作用を対象としています。完成品の品質基準や、工場の自動化率を一律に定めたものではありません。また、規格は生産システムをどのように記述するかを示すもので、既存の安全要求、設備認証、情報セキュリティ対策を置き換えるものでもありません。

ここで中国の政策動向を分けて見ておきます。工業情報化部など6部門は2026年7月、スマート工場の段階的育成に関する通知を公表しています。基礎級・先進級・卓越級・領航級という枠組みで、製造業のデジタル化と高度化を進める政策です。[3]しかし、これはGB/T 47859-2026の全工場への採用義務を意味しません。政策の方向性と個別規格の法的拘束力は、別の論点なのです。

私は、規格への「適合が必要か」と「設計思想を次の投資に生かすべきか」を別々の会議事項にする方が実務的だと考えます。前者は法務・顧客契約・品質保証の確認、後者は経営・工場・情報システムの投資判断です。最初にその線を引くだけでも、議論の混乱は減ります。ちなみに、規格に関連する中国の制度や顧客要求を確認することと、標準本文の技術的な適用範囲を確認することも別作業です。「国家標準になった」というニュースだけで、投資稟議の結論を決めるべきではありません。

設備ではなく、「設備ができること」をどう表すのか

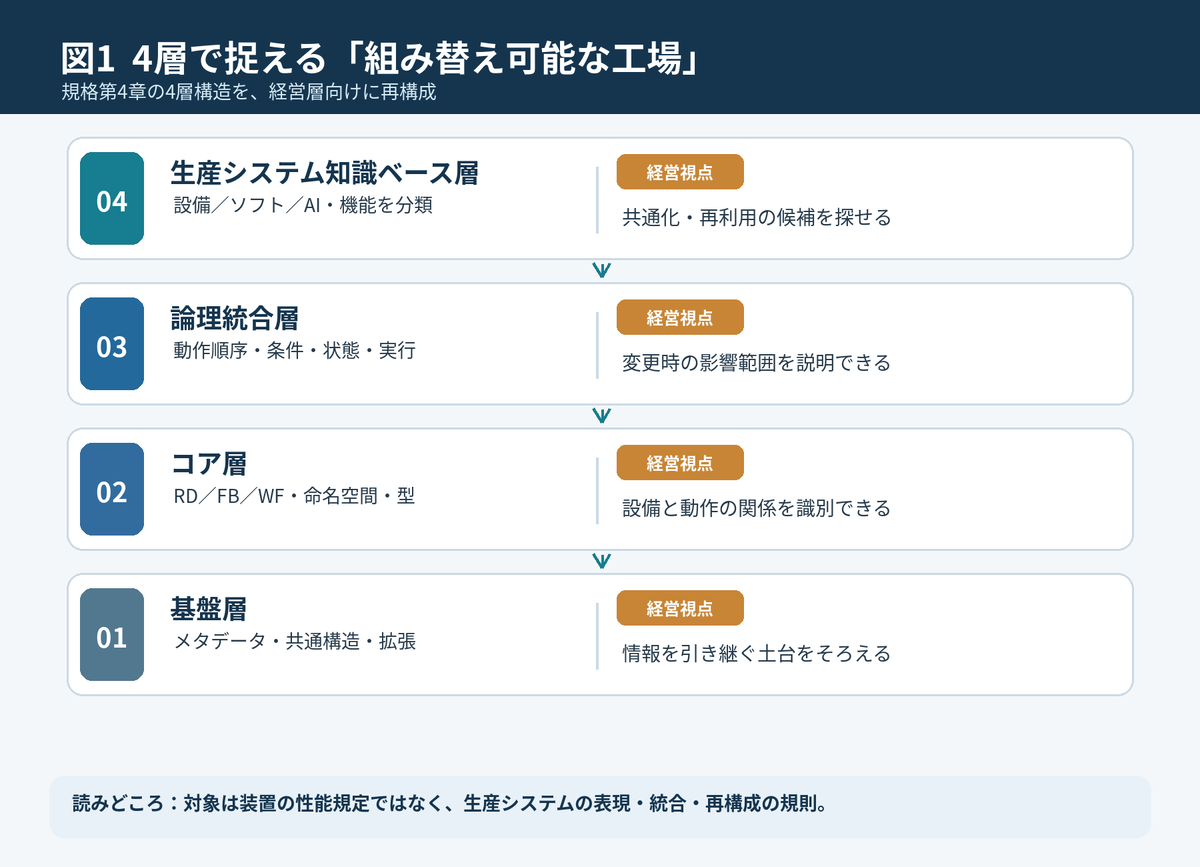
規格を理解するための出発点は、生産システムを4つの層で表す「システムアーキテクチャ」です(規格4)。最下層の「基盤層」はメタデータや共通構造、拡張方法を扱います。「コア層」はリソース記述、機能ブロック、ワークフローに使う基本オブジェクトや名前空間を定義します。「論理統合層」は動作の順序や条件、状態を組み合わせます。最上層の「生産システム知識ベース層」は、それらを分類し、検索・再利用できるように整理します。

技術的には抽象的に見えますが、考え方は明快です。これまで個々の設備に埋め込まれていた情報を、名前と構造を持つ共通の要素として扱うのです。規格では、モデルをメタデータ、ユーザーインターフェース情報、データ、リソースに分ける共通構造(規格5.2)と、モデルの要素を一意に識別する名前空間の規則(規格6.2)が示されています。設備ごとに名称やデータ型がばらばらでは、後から関係を追うことも変更することも難しくなります。

その上で、規格が定義するリソース記述(RD)は、動作を行う主体を表します。例えばロボット、制御装置、ソフトウェア、あるいは人です。一方、機能ブロック(FB)は「搬送する」「検査する」「把持する」といった動作を表します。複数の動作を組み合わせ、手順として実行するものがワークフロー(WF)です。規格では、RDを主語、FBを述語として説明し、同じ機能ブロックを複数の動作主体に結び付け得るモデルを示しています(規格6.3.9)。

仮に、製品をカメラで確認し、ロボットが取り上げ、別の位置へ運ぶ工程があるとします。規格が例示する「把持して置く」という複合動作は、ロボット、把持具、産業用カメラといった複数の主体に結び付けて表現できます(規格6.3.9、規格原文の図6)。[1] 動作の定義と、それを実行する機器を区別しておけば、設備交換の際、影響する部分を切り分けやすくなります。

別の仮想例として、「ねじを締める」工程を考えてみます。A社製装置の専用コントローラーに、ねじ締めの順序、締付条件、設備固有の命令が一体化していると、装置を替えるときにノウハウをプログラムから読み解き直す負担が生まれます。そこで「ねじを締める」という業務上の動作、許容条件、測定結果を機器固有の呼び出しから分けて記述できれば、新しい機器を接続する際の設計・検証範囲を特定しやすくなるでしょう。残したい資産は、A社製装置のコードそのものだけではなく、自社が決めた工程の条件と判断の根拠なのです。

ただし、ここは誤解したくないところです。モデル上で同じ「移動」という動作を表現できても、異なる機械が安全かつ同一の精度で動くことが保証されるわけではありません。座標系、能力、入出力、応答時間、安全条件、例外処理を個別に確認する必要があります。規格が提供するのは変更を考えやすくする共通言語であって、すべての装置を無条件に差し替える魔法ではありません。「設備更新工数が半減する」といった効果も、この規格だけからは導けません。削減効果を主張するなら、更新前後の実測や条件をそろえた比較が必要です。

「組み替えられる工場」は、単なる柔軟生産と何が違うのか

製造業では以前から「多品種少量に強いライン」「柔軟な設備構成」が重視されてきました。しかし、機械的に段取り替えができることと、システムとして工程を再構成できることは同じではありません。設備の移動が容易でも、制御ソフトウェア、データ、作業手順が個別仕様のままなら、工程変更のたびに別の調整が発生します。

この問題に対し、規格では「論理統合層」という仕組みを設けています。ここで中心的な役割を果たす産業用ビヘイビアツリーは、動作を順序、並列、条件などで組み合わせるための仕組みです。さらに、動作の状態を「IDLE(未実行)」「RUN(実行中)」「OK(成功)」「FAIL(失敗)」という4つの基本状態で表しています(規格7.3)。工程を図形で並べて終わりではなく、何を実行して、どの結果が返り、次に何をすべきかをモデルに含める考え方です。

例えば、検査工程で異常が発生したとき、単純に後続の搬送装置を動かしてしまえば、品質問題だけでなく安全上の問題にもつながります。そこで、検査が成功した場合だけ次の動作へ進み、失敗時には停止や人による確認へ移る、といった分岐が必要になります。規格では、IDLE/RUN/OK/FAILの状態を扱うほか、高信頼性が求められる産業用途を念頭に、機能ブロックがhalt()で停止を試み、exception()で異常を処理・復旧を試みる方法を示しています(規格7.3)。[1]

ここが通常の「作業の順番を図にしただけ」のフローとの重要な違いです。成功時の進行だけでなく、実行中・失敗・停止要求といった異常系の振る舞いをモデルの中で検討できることに意義があります。ただし、halt()は安全停止を「試みる」と記述されており、それだけで非常停止や安全回路の要求を満たすと断定することはできません。実機での安全対策と検証は別途不可欠です。

経営層が見るべきポイントは、工程変更のたびに「誰かが頭の中で知っている手順」を作り直していないか、ということです。設計情報が体系化されていれば、変更箇所やテスト対象を整理しやすくなります。逆に、図面はあっても、稼働条件、異常時の挙動、設備同士の前後関係が担当者の経験に依存していれば、変更のたびに同じ確認を繰り返すことになります。

ここで求められるのは、自動化率をむやみに上げることではありません。人が判断する場面を含め、「どの条件で、誰が、どの動作を行うのか」を明確にできる工場です。附属書Aには、工站内の階層的ワークフローや、生産システムのライフサイクルにおけるモデルの利用例が収録されています。詳細を見たい方は、日本語全文参考訳の附属書A.2およびA.3を参照してください。

産業AIエージェントが規格に登場する意味

今回の規格で特に興味深いのは、AI能力を独立した資源分類として扱っていることです。具体的には、AIモデル、AI推論サービス、産業AIエージェントの3つが区別されています(規格8.2.5)。AIモデルは予測や認識などを行うための学習済みの実体、AI推論サービスはモデルを実行して結果を返すサービス、産業AIエージェントは産業上の目的に向けてタスクを判断し、工程を調整するソフトウェア上の主体として位置づけられています。

この分類から私が読み取るのは、AIを工場の外側に置く「便利な分析ツール」だけとしてではなく、生産システムの中で呼び出され、他の資源や動作と関係付けられる要素として扱う設計思想です。この分類では、AIモデルのアルゴリズム実装の詳細は対象外とされており、AIエージェントの呼び出しや調整に必要な役割を資源として捉えています(規格8.2.5)。[1] ただし、学習方式、精度基準、操作権限や承認者を一律に定めているわけではありません。実装の安全性、責任範囲、承認手続きは企業側で設計する必要があります。

例えば、設備の稼働状況から異常の可能性を予測し、保全担当者に作業提案を出すAIを考えます。最初は「提案を表示する」だけでも、将来、点検計画の変更や設備停止の要求につなげる場面が出てくるかもしれません。ここで必要になるのは、「AIが設備のどの状態を参照できるか」「どの動作を呼び出せるか」「実行前に誰の承認が必要か」「失敗時には誰が止めるか」という責任と権限の設計です。

RDやFBの表現は、操作対象と動作を整理する際の土台になり得ます。しかし、権限管理、人的承認、監査ログ、安全停止を、この規格が完成済みの仕組みとして提供しているわけではありません。これは規格本文から直接の義務を導く話ではなく、AIエージェントを工場に導入する場合に私が追加すべきだと考える設計項目です。予測、提案、承認、実行を別の段階として管理できれば、AIの能力を使いながら責任の所在を曖昧にしにくくなります。

附属書Bの表B.3にはMCP(モデルコンテキストプロトコル)が通信プロトコルの名前空間例として、表B.11にはERP、MES、WMSなどがソフトウェア分類例として登場します。[1] AIが設備やシステムに接続する将来を考える際、興味深い記載です。ただし、MCPを使うことが義務になったわけではなく、MCP経由の操作権限や安全措置がこの附属書で定義されたわけでもありません。名前が掲載されたことを、実装認証や相互運用性の保証と取り違えないことが重要です。

AIを取り入れる際の経営判断は、「どのモデルを買うか」から始めるより、「どの動作まで機械に委ねるか」「例外時に誰が止められるか」「判断の記録を残せるか」を明確にする方が先だと思います。AIを導入した後の制御可能性は、精度と同じくらい重要だからです。

日系工場で見落とされやすい、三つの制約

この標準が示す方向性を日系工場へ当てはめるとき、一律の導入論には慎重であるべきです。ここからは規格の要求そのものではなく、経営上の検討事項として整理します。私が重視する制約は、設備構成、情報の分断、変更する権限の三つです。

第一は、異なる年代・メーカーの設備が混在していることです。最新設備には外部接続の仕組みがあっても、長年稼働する専用機には十分な資料や標準インターフェースがない場合があります。規格に適したモデルを採用する前に、現在の設備が何を公開でき、何を変更できないかを確かめる必要があります。古い設備をすべて取り換えることが最善とは限りません。

第二は、情報と制御の分断です。ERPで受注や購買を管理し、MESで製造実績を取り、別のシステムで設備を制御する。さらに現場ではExcelや紙による補完作業が残る場合があります。規格が扱うのは、これらの業務システムを一つの製品へ統合することではありません。異なるIT・OT資源をどう表現し、どの機能に結び付けるかという建模の問題です。データが一致していない状態でモデルだけを整えても、意思決定の質は上がりません。

第三は、設備の所有権と、プログラムや設計情報を変更できる権利が一致していない可能性です。専用機を購入しても、プログラムの変更が特定ベンダーに限定される契約であれば、自社が自由に工程を再編できるとは限りません。ソースコード、インターフェース仕様、設定値、試験記録、利用許諾、保守体制をどこまで引き継げるか。これは標準への適合以前に、調達契約と技術資産管理の問題です。

図3は説明のための仮想例であり、特定企業の実績ではありません。重要なのは、モデル化すれば変更費用が必ず下がると決めつけないことです。新たなモデルの整備、担当者教育、外部との検証には費用がかかります。対象となるラインの変更頻度、設備寿命、停止による損失を考慮しなければ、投資対効果を誤ります。技術の選択肢が増えることと、今すぐ投資すべきことは別です。

どの工場から取り組むべきか

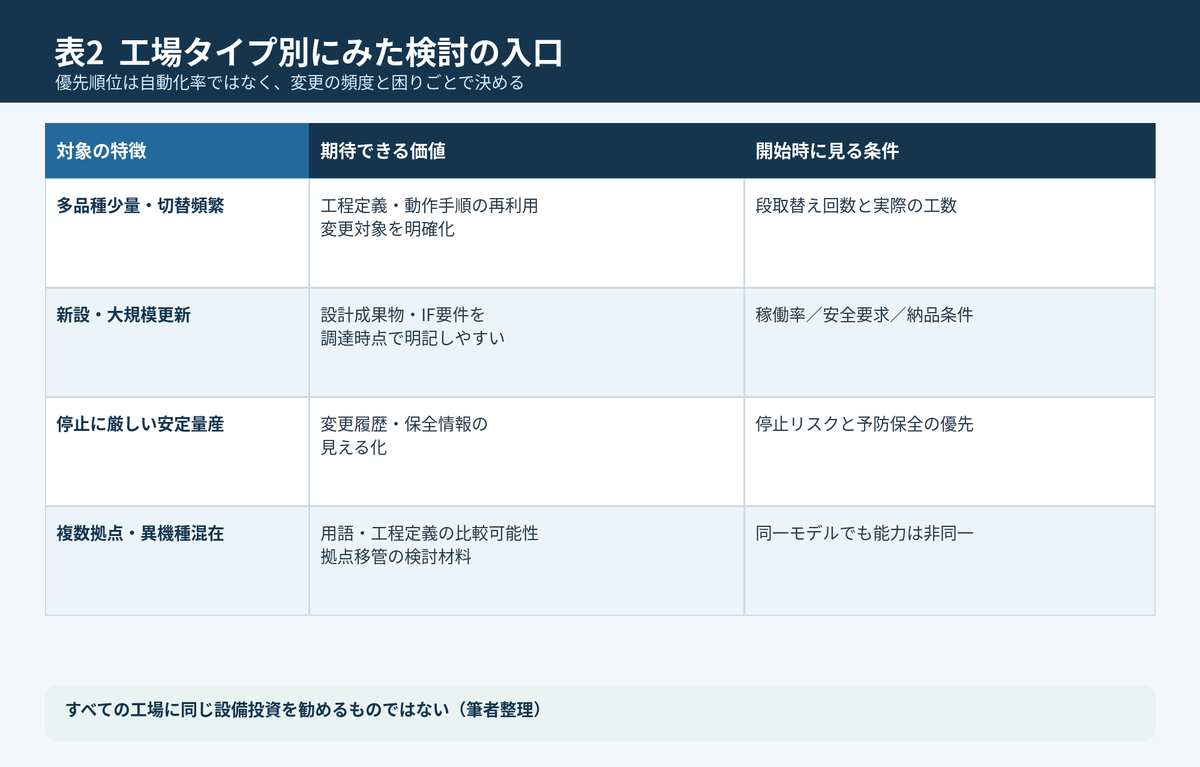
では、中国に工場を持つ日本企業は何から始めればよいのでしょうか。答えは工場によって違います。多品種少量で製品切替が頻繁な工場と、安定した製品を長期間大量生産する工場では、システムを再構成することから得られる便益が異なります。新設ラインと、償却が進んだ既存ラインでも、変更コストは同じではありません。

例えば、多品種少量工場では段取り替えや装置変更の頻度が高いため、工程に関する知識を共通の単位で管理する価値が大きくなりやすい。一方、設備の停止が許されない連続生産の工場では、再構成の柔軟性よりも稼働安定性や安全性が優先される局面があります。どちらが先進的かという優劣ではなく、何を改善する必要があるかの違いです。

新設ラインや更新計画のある工場は比較的検討を始めやすいでしょう。これから調達する設備に、インターフェース資料、動作定義、設定データの引渡し、改修時の試験方法を要件として組み込めるからです。既存ラインでも、問題の多い工程一つに対象を限定し、現状のモデル化と変更時の差分確認から始めることはできます。

また、中国内に複数工場を持つ企業では、同じ工程名でも拠点ごとに設備構成が異なることがあります。そうした場合には「全拠点を同じ装置へ統一する」ことと、「工程の定義やデータ項目を比較できるようにする」ことを分けて考える方が合理的です。工場間で比較可能な情報が増えれば、設備更新や立上げの判断に役立ちますが、標準モデルへの統一だけで品質や生産性が自動的に改善するわけではありません。

したがって、最初の投資判断は大規模な導入計画ではなく、「どの工程の変更に最も時間がかかっているのか」を特定することから始めたいと思います。設備を替えるたびに同じトラブルが起こる、改造した理由が追跡できない、新しい担当者が立上げに苦労する。そうした困りごとが見つかったとき、この規格の考え方を使う意味が具体的になります。

次の設備投資で「会社に残すもの」を変える

設備投資の稟議では、本体価格、能力、納期、稼働率、回収期間などが中心になりがちです。それらは不可欠ですが、私はもう一つ、「導入後に会社へ残る情報資産」を判断項目に加えるべきだと考えています。どの設備を買ったかだけでなく、設備の動き方や他のシステムとの関係を、企業自身が理解し、変更できる状態で残せるかということです。

具体的には、機器・ソフトウェアの一覧とバージョン、入出力・通信インターフェース仕様、設備が実行できる動作の定義、ワークフロー、異常時の処理、検証記録、変更履歴などが考えられます。この規格では、モデルの共通構造、設備や機能を識別する名前空間、動作を記述する基本オブジェクト、工程の実行論理などが体系的に定義されています。これらは、設備やシステムに関する情報を整理し、将来の変更に備えるうえで参考になる考え方です。[1] ただし、ここで列挙したすべての資料を規格が一律に納品義務として要求しているわけではありません。自社に残す成果物を調達仕様書で定義するのは、企業自身の仕事です。

実務では、調達仕様書に「標準に適合すること」と一行書くだけでは十分ではありません。何を対象に、どの版・条項を採用し、どの成果物で確かめるのかが曖昧だからです。例えば、①RD・FB・ワークフローに相当するモデル定義とインターフェース仕様、②編集できる元データ・設定・必要なソースコード、③変更履歴・試験記録・復旧手順、④保守移管時の支援条件を、それぞれ納品・検収の対象とするか決めます。

ここで避けて通れないのが、知的財産と契約条件です。装置を購入したからといって、ベンダーが保有するプログラムやツールの著作権まで自社へ移るとは限りません。すべてのソースコードの譲渡を一律に求めれば、見積額の上昇や交渉難航も起こり得ます。自社に不可欠な工程定義の利用権、改変権、第三者への保守委託の可否、設計データの引渡し方法、ベンダー固有技術の秘密保持を、対象ごとに切り分けて協議する必要があります。

これらはサービス稼働率を定めるSLAと同じものではなく、調達仕様・成果物・検収条件・ライセンス条項の設計です。中国現地のSIerや設備メーカーとの契約で具体化し、日本本社の調達・法務・技術部門が必要な共通原則を支える。実設備に影響する制御変更では、モデルの再利用とは別に、安全性・性能・サイバーセキュリティの評価を行うことが前提です。

投資効果は、工程の切替時間、設備改造時の追加工数、立上げ期間、外注改修費、停止時間、変更に伴う不具合など、自社が把握できる指標で測ります。新しい設備が導入された時点の数字だけでなく、次の製品変更や設備交換が発生したときに、費用と時間がどう変わるかを追う必要があります。

重要なのはベンダーを排除することではありません。優れた技術を持つ外部企業と協力しながらも、業務上の重要な設計判断と引継ぎ可能な成果物を自社に残すことです。特定の担当者や会社に頼るしかない状態を緩和できれば、技術選択の自由度は高まります。それこそが、この規格の考え方を経営に取り込む実利ではないでしょうか。

日本本社と中国現地法人が、それぞれ決めること

最後に、このテーマを本社と現地法人の役割へ落とし込みます。技術標準は工場だけで導入しても、本社だけで決めても機能しにくいものです。中国現地の製品構成や設備事情を知らずに一律の更新を指示すれば、不要な投資を生むおそれがあります。逆に、拠点ごとに個別最適の導入を続ければ、将来の比較や移管が難しくなります。

私が提案したいのは、本社が「変えてはいけない共通部分」を定め、現地法人が「現場に合わせて変える部分」を選ぶ分担です。本社は用語、識別子、主要データ項目、セキュリティ上の最低要件、成果物の帰属と引継ぎ条件などを統一する。一方で現地法人は、対象工程、既存設備との接続方法、保守会社の選定、立上げ順序、工場停止の許容範囲などを現実的に判断する。これは規格が定める組織責任ではなく、日系企業向けの運営案です。

最初から全工場で統一モデルを構築する必要はありません。まず現状を棚卸しし、工程変更が頻繁で困りごとの明確な場所を選びます。次に、既存の仕様をRD・FB・WFの考え方で整理し、変更時に何が再利用できるのかを小さく検証する。その結果を設備調達の仕様や技術資産の管理方法へ反映し、効果が出た場合に限って他工程や他拠点へ展開する。私はこの順序が妥当だと考えます。実証に進む条件と、途中で中止する条件を最初に決めることも重要です。

評価の際には、成功したケースだけを集めないことも大切です。モデル整備の工数が重すぎた、保守が複雑になった、外部の制御ソフトウェアと合わなかった、といった結果も次の判断材料になります。投資を進めるための実証ではなく、進めるかどうかを判断するための実証にするわけです。

実務担当者に任せきりにせず、本社経営層と現地総経理・工場長が共通の質問を持つことが重要です。「この設備更新で何が変わるのか」「次の変更時に残る成果物は何か」「その成果物を誰が管理し、誰が使えるのか」。この三つへの回答が具体的であれば、規格の採用そのものを目的にしなくても、設備投資の質を高められるはずです。

まとめ

今回、GB/T 47859-2026の全文を読んで強く感じたのは、中国のスマート工場政策を「工場の自動化競争」という言葉だけで捉えると、この規格が持つ意味を見落とすということです。新標準が扱うのは、設備の性能だけではなく、設備を動かす機能と工程を共通のモデルとして記述し、変更に対応できる生産システムを構築するための基盤です。

ただし、標準が示す設計思想を、そのまま各社の投資義務に読み替えることはできません。事業や設備の構成、顧客契約、変更頻度、社内の技術人材によって、取り組むべき範囲も優先順位も違います。大切なのは、自社の工場が何を変えられずに困っているのかを確かめることだと思います。

私は、日系企業にとっての問いを「中国の新標準に合わせるか」だけに置きたくありません。次に設備を更新するとき、何が自社の技術資産として残るのか。次の製品を立ち上げるとき、どこまで設計と知識を引き継げるのか。複数拠点で生産を見直すとき、どの情報を共通言語として扱えるのか。そこに経営判断としての本質があると考えています。

本文で取り上げた内容を、規格の条項・用語・図表に沿って詳しく確認したい方に向けて、GB/T 47859-2026 日本語参考訳(PDF・66ページ/非公式・原文対照版)を公開しています。規格本文の第1〜8章、附属書A〜C、表の日本語・中国語対照、原図と主な図中文字の用語対照を収録した資料です。社内の技術検討、設備調達仕様、工場システムの設計方針を議論する際の参考資料としてご活用ください。

日本語参考訳PDF(Google Drive) 日本語参考訳PDFを閲覧・ダウンロード(Google Drive) ※本資料は公定訳ではありません。翻訳・一般配布の許諾を得て公開しています。正式な解釈や設計・適合判断には中国語原文を優先し、必要な法令や個別契約もご確認ください。

今回はここまでとします。 最後までお読みいただき、ありがとうございました。

参考資料

[1] GB/T 47859-2026「智能工厂 生产系统可重构建模规则」原文(中国国家標準)。2026年7月2日公布、2027年2月1日実施予定。特に序文、適用範囲、システムアーキテクチャ、基盤層、コア層、論理統合層、生産システム知識ベース層、附属書A〜C。

中国国家標準全文公開システム:https://openstd.samr.gov.cn/bzgk/std/newGbInfo?hcno=87869823E2F6225A4A48DE03C4B984FF

[2] 中華人民共和国標準化法(2017年改正)第2条、第26〜27条。中国国家市場監督管理総局。

https://www.samr.gov.cn/zw/zfxxgk/fdzdgknr/fgs/art/2023/art_d7040b9f1d0f4980a0e55089a57bf37d.html

[3] 工業情報化部等6部門「2026年度スマート工場段階的育成行動に関する通知」(2026年7月17日掲載)。

https://wap.miit.gov.cn/jgsj/zbys/wjfb/art/2026/art_0b146d4cdb0a4d82bbfd004fd9836db5.html

※図1・図2は規格の技術的構造を参照して筆者が再構成した図、図3・図4および表1〜3は筆者の経営上の考察を含む独自の整理です。規格の原図・原表の転載ではありません。

※仮想例と提言は著者による解釈であり、規格の要求事項そのものとは区別しています。

10回シリーズ「モノは世界でつながっても、情報はつながらない」――グローバルSCMの裏側にある、IT・DX・人の壁 第10回(最終回)

第10回 グローバルITで、何を揃え、何を任せるのか

前回は、本社の標準と海外拠点の現実をどう折り合わせるのかを考えました。

本社には、グループ全体を統制し、データを比較可能にし、セキュリティや内部統制を揃えたいという合理性があります。

海外拠点には、現地法制度、顧客要求、物流事情、設備、人員、商習慣という現実があります。

そこで、

必ず共通にする。

結果は揃えるが、方法は任せる。

現地に任せる。

という「3つの領域」で整理しました。

そして最後に、こんな問いを残しました。

システムは、どこまで共通にするのか。

データは、何を揃えるのか。

業務プロセスは、何を標準化するのか。

判断は、どこまで本社が持つのか。

現場には、何を任せるのか。

海外拠点には、どこまで裁量を残すのか。

この10回シリーズの最終回では、この問いに一度答えを出してみたいと思います。

「全部同じ」にしても、なぜつながらないのか

このシリーズの第1回は、

「モノは世界でつながっても、なぜ情報はつながらないのか」

という問いから始まりました。

製品は工場を出て、船やトラックに載り、国境を越えて顧客へ届く。

ところが会社の中を見ると、受注情報が更新されていない。

在庫の数字が拠点ごとに違う。

仕入計上のタイミングがずれる。

現場は状況を知っているのに、本社の会議資料にはまだ反映されていない。

そこで、一つの製品には、

モノ。

情報。

カネ。

意思決定。

という複数の流れがあると考えました。

その後の9回でも、形を変えながら、何度も似た問題に戻ってきました。

第2回では、同じシステムを使うことと、同じ仕事をすることは同じではないと考えました。

第3回では、すべての既存システムを一つに置き換えるのではなく、残す・つなぐ・移す・やめるを選び、接点を設計する必要があると考えました。

第4回では、ERP、PLM、MES、WMSが分かれているのは、目的・時間軸・粒度が違うからだと考えました。

第5回では、同じ製品を見ていても、コード、定義、単位、時点、原本が違えば、データは一致しないと考えました。

第6回では、データを集めても、それだけでは良い意思決定にならないと考えました。

第7回では、技術的につながることと、国境を越えて自由にデータを扱えることは同じではないと考えました。

第8回では、システムが稼働したことと、現場の仕事が新しい仕組みに定着したことは同じではないと考えました。

そして第9回では、本社標準を世界へ広げることが、そのままグローバル標準になるわけではないと考えました。

こうして振り返ると、このシリーズでは何度も、

「同じにすること」と「つながること」は、同じではない。

という問題に戻ってきたことが分かります。

もちろん、標準化は重要です。

共通の仕組みがあるから比較できる。

共通のルールがあるから統制できる。

共通のデータがあるから、拠点を越えて判断できる。

しかし、「揃えること」そのものが目的になると、本来つなぎたかった仕事が、かえって動きにくくなることがあります。

では、何を揃えるべきなのでしょうか。

揃えるべきなのは、「共通の核」

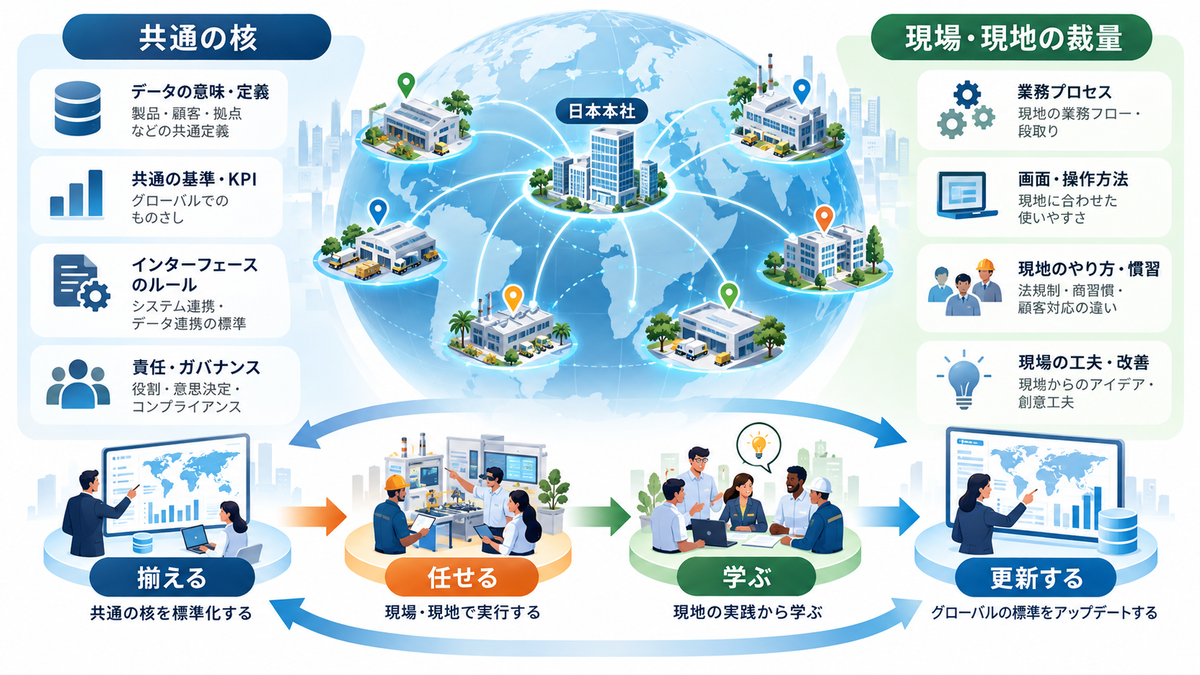
私は、世界中の仕事を同じにするのではなく、世界で協働するために必要な「共通の核」を揃えることが重要だと思います。

その核は、少なくとも4つに整理できます。

一つ目は、意味です。

「在庫」とは何を指すのか。

「受注済」とはどの状態なのか。

「出荷済」とは、工場から出た時点なのか、倉庫から出た時点なのか、顧客へ引き渡した時点なのか。

「売上」は、どのタイミングで認識するのか。

同じ言葉を使っていても、意味が違えば、数字を集めても比較できません。

第5回で見たように、データを揃えるとは、数字を一つにすることよりも、その数字が何を意味するのかを揃えることです。

二つ目は、基準です。

品質基準。

セキュリティの最低基準。

共通KPIの定義。

トレーサビリティの要求水準。

内部統制上、守らなければならない条件。

すべての拠点が同じ作業をする必要はなくても、企業として守るべき最低線は必要です。

三つ目は、接続の約束です。

どのデータを渡すのか。

いつ渡すのか。

どの単位で渡すのか。

エラーが起きたらどうするのか。

どちらを正とするのか。

第3回で、異なるシステムをつなぐためには「つなぐ」という言葉だけでは足りないと考えました。

会社全体でも同じです。

拠点やシステムが違っても、接点の約束が揃っていれば、仕事はつながりやすくなります。

四つ目は、責任です。

どのデータが原本なのか。

誰が修正できるのか。

誰が判断するのか。

誰が例外を承認するのか。

誰が結果に責任を持つのか。

システムを世界で統一しても、責任の所在が曖昧なら、問題が起きたときに仕事は止まります。

反対に、システムが違っていても、意味・基準・接続の約束・責任が揃っていれば、グループとしてかなり強くつながることができます。

つまり、

グローバルITで揃えるべきなのは、「同じ画面」より、「同じ意味・基準・接続条件・責任」。

なのだと思います。

「実現方法」まで、すべて揃える必要はない

共通の核を揃える一方で、すべての実現方法まで揃える必要はありません。

例えば前回、トレーサビリティについて考えました。

「どのロットの部材が、どの完成品に使われたかを2時間以内に追跡できる」

という要求はグループ共通にする。

一方、大規模工場では二次元バーコードとハンディ端末でリアルタイムに取得する。

小規模拠点では、作業指示票を使い、決められたタイミングで登録する。

必要な時間内に追跡でき、正確性が確保されるなら、目的は満たせます。

同じことは、在庫管理、品質管理、承認、物流、顧客対応などにも当てはまります。

在庫精度の基準は揃える。

しかし棚卸しの方法は、倉庫の規模や設備に合わせる。

承認権限の原則は揃える。

しかしPCで承認するか、モバイルで承認するかは、現地の働き方に合わせる。

セキュリティ基準は揃える。

しかし具体的な運用は、利用するシステムや現地のIT環境に合わせる。

顧客へ提供するサービス水準は揃える。

しかし現地顧客固有の帳票や物流会社との連携方法は、現地へ任せる。

ここで重要なのは、

「任せる」と「放置する」を混同しないこと。

です。

任せるとは、何をしてもよいという意味ではありません。

共通の核を守る。

責任範囲を明確にする。

必要な結果を満たす。

その条件の中で、現地が最も合理的な方法を選べるようにする。

それが「任せる」ということだと思います。

揃えるか、任せるかを決める「4つの問い」

では、実際のプロジェクトで、何を揃え、何を任せればよいのでしょうか。

「これはグローバル標準です」

「これはローカル要件です」

というラベルだけでは、答えは出ません。

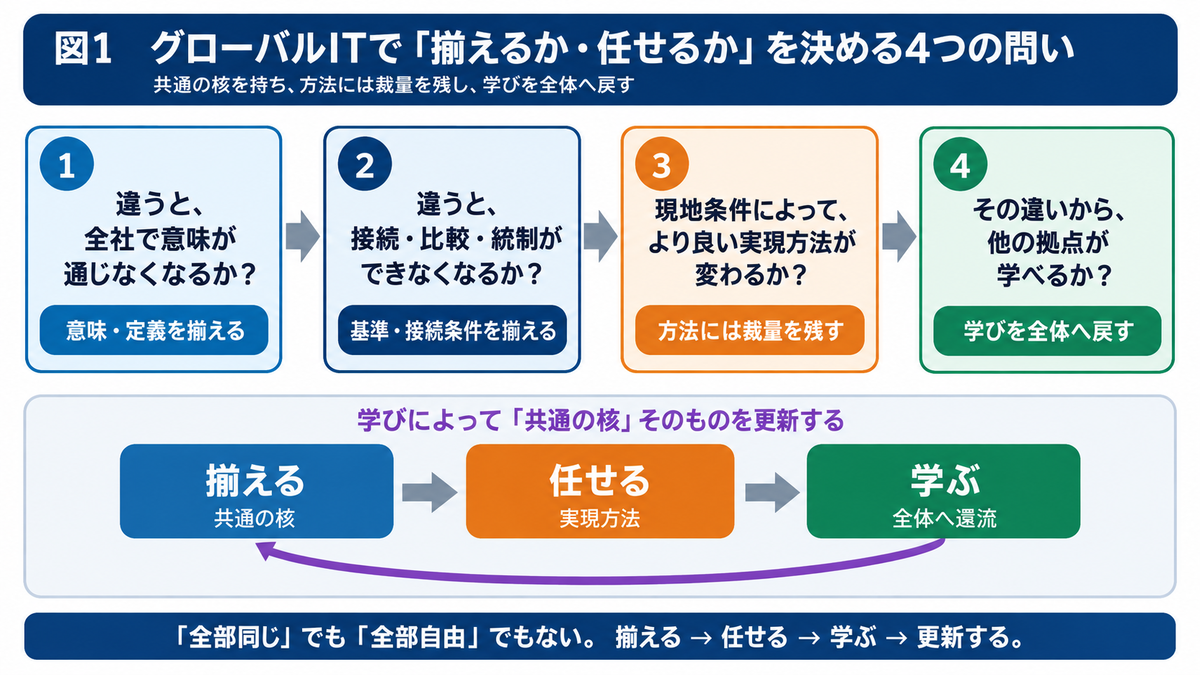
そこで、何かを標準化しようとするとき、次の4つの問いを置いてみます。

一つ目の問いは、

違うと、全社で意味が通じなくなるか。

です。

例えば、在庫、受注、売上、品番といった基本的な言葉の定義が拠点ごとに違えば、数字を集めても会話が成立しません。

この場合は、揃える方向で考えた方がよいでしょう。

二つ目は、

違うと、接続・比較・統制ができなくなるか。

です。

セキュリティの最低基準。

システム間のデータ連携条件。

グループ共通KPIの定義。

内部統制上必要なルール。

これらは、違いを放置するとグループ全体がつながらなくなります。

ここも共通の核として揃える領域です。

三つ目は、

現地条件によって、より良い実現方法が変わるか。

です。

設備規模。

人員構成。

顧客要求。

物流事情。

法制度。

IT環境。

こうした条件によって最適な方法が変わるなら、結果や条件だけを揃え、方法には裁量を残す余地があります。

そして四つ目は、

その違いから、他の拠点が学べる可能性はあるか。

です。

これは、「揃えるか」「任せるか」の判断で終わらせないための問いです。

ある海外工場で生まれた省人化の工夫。

ある販売会社で使われているモバイル承認。

ある国で進んだデジタル取引への対応。

ある現場が作った、より分かりやすい在庫管理方法。

それらが他拠点にも価値を持つなら、単なるローカル例外として閉じる必要はありません。

本社や他拠点へ戻し、検証し、必要なら共通の仕組みそのものを更新する。

つまり、この4つの問いは、

揃える。任せる。学ぶ。更新する。

という循環につながります。

任せても分断しないために、「境界」を設計する

現地へ裁量を渡す話をすると、よく出てくる不安があります。

「それでは、またバラバラになるのではないか」

という不安です。

その通りだと思います。

「現地に任せる」だけでは、各拠点が独自システム、独自コード、独自KPI、独自手順を作り始める可能性があります。

だから必要なのは、自由か統制かを選ぶことではなく、境界を設計することです。

ここまでは全社共通。

ここからは現地判断。

この条件を外れる場合は本社とレビューする。

このデータは必ず本社へ共有する。

この例外には期限を置く。

この改善は他拠点でも検証する。

この境界が明確なら、現地へ任せても全社として分断しにくくなります。

逆に、境界が曖昧なまま「グローバル標準だから守ってください」と言えば、現場には過剰な統制として見えます。

「現地で判断してください」と言いながら、本社が後から判断を覆せば、現地は裁量を信用しなくなります。

第6回では、データを見るだけでなく、「誰が何を決めるのか」を設計する必要があると考えました。

第9回では、標準を作るだけでなく、「誰がどこまで決めてよいか」を決める必要があると考えました。

ここまでを一つにすると、

ガバナンスとは、すべてを本社が決めることではない。誰が、どこまで決めてよいかを決めることである。

と言えると思います。

そして、この境界はシステムだけの話ではありません。

データ。

業務プロセス。

KPI。

セキュリティ。

投資。

例外処理。

人の判断。

どこまで揃え、どこから任せるのかを、会社として設計する必要があります。

第1回で、一つの製品には「モノ・情報・カネ・意思決定」という複数の流れがあると考えました。

モノだけが速く動いても、情報が止まれば仕事は止まります。

情報が届いても、カネの認識がずれれば数字は合いません。

数字が揃っても、誰も決めなければ動きません。

情報・カネ・意思決定の流れが整って初めて、世界を流れる「モノ」に血が通う。

そのための境界を設計することも、グローバルITの重要な役割なのだと思います。

グローバルITは、「完成した仕組み」ではなく「学習する仕組み」

ここまでの話には、一つ前提があります。

最初から完璧な答えを作ることは難しい、ということです。

新しいシステムを設計する。

海外へ展開する。

現場で使う。

想定していなかった摩擦が見つかる。

現地で工夫が生まれる。

その工夫を本社へ戻す。

他拠点でも試す。

良ければ標準へ取り込む。

そして、また使う。

第9回では、グローバル標準は「完成品」ではなく、世界の拠点から学びながら更新される仕組みだと考えました。

同じことは、グローバルIT全体にも言えると思います。

ERPを導入したら終わりではない。

データ基盤を作ったら終わりではない。

ダッシュボードを公開したら終わりではない。

各拠点を同じシステムへ移行したら終わりでもない。

使われ方を見る。

例外を見る。

現場の摩擦を見る。

意思決定が変わったかを見る。

新しい工夫を見る。

そして、仕組みそのものを更新する。

この循環がなければ、今日のグローバル標準は、やがて明日のレガシーになります。

反対に、各拠点で生まれる違いを、単なる「標準からの逸脱」としてではなく、学習の材料として扱える組織は、標準そのものを進化させることができます。

だから、

最も強いグローバルITは、最初から完璧に統一された仕組みではなく、違いから学び、更新できる仕組みである。

のだと思います。

まとめ:つながるために、すべてを同じにする必要はない

10回にわたって、グローバルSCMの裏側にあるIT・DX・人の壁について考えてきました。

最初の問いは、

「モノは世界でつながっているのに、なぜ情報はつながらないのか」

でした。

ここまで考えてきて、最後に一つの整理をするなら、私はこう考えます。

揃えるもの。

意味。

基準。

接続の約束。

責任。

任せるもの。

実現方法。

現地固有の対応。

現場の工夫。

改善の方法。

そして、もう一つ重要なものがあります。

任せた先で生まれた学びを、もう一度全体へ戻すこと。

この循環があるから、「標準」と「現地適応」を両立できます。

モノは、物流によって世界を移動できます。

情報も、ネットワークを使えば世界へ送ることができます。

しかし、それだけでは、一つの会社として「つながった」とは言えません。

同じ数字を、同じ意味で理解できる。

必要な基準を共有している。

システムや拠点の間に、接続の約束がある。

誰が判断し、誰が責任を持つかが分かる。

共通にすべきところは共通にし、違ってよいところには裁量がある。

そして、ある拠点で生まれた学びが、別の拠点や本社へ戻っていく。

その状態を作ることが、グローバルITの役割なのではないでしょうか。

グローバルITとは、世界中を同じにする仕組みではありません。

違いを残したまま、それでも一つの企業としてつながれるように設計すること。

そのために、何を揃え、何を任せるのかを考え続ける。

それが、この10回シリーズを通じて見えてきた一つの答えです。

つながるために、すべてを同じにする必要はない。

この言葉を、シリーズの最後に置きたいと思います。

今回はここまでとします。
最後までお読みいただき、ありがとうございました。